Une fois que vous avez collecté vos données, effectuez une analyse exploratoire des données pour identifier et résoudre les problèmes de qualité des données. Il s'agit d'une étape essentielle du processus de Marketing Mix Modeling (MMM), car elle vous permet d'évaluer les données pour confirmer qu'elles représentent de manière précise les efforts marketing, les réponses des clients et d'autres métriques pertinentes. En corrigeant les problèmes détectés lors de l'analyse exploratoire des données, vous pouvez améliorer la fiabilité de la sortie du modèle.
Le processus de base pour effectuer une analyse exploratoire des données est le suivant :
- Examinez les données afin d'identifier les données manquantes ou incomplètes.
- Corrigez les valeurs manquantes dans vos fichiers d'entrée bruts.
- Évaluez l'exactitude des données.
- Corrigez les anomalies, les données aberrantes ou les imprécisions dans les données.
- Vérifiez la corrélation entre vos KPI et vos variables média et de contrôle.
Package AED de Meridian
Le package AED de Meridian vous aide dans ce processus en générant un rapport HTML d'analyse exploratoire des données (AED) que vous pouvez exporter vers votre Google Drive. Ce rapport HTML fournit des visualisations et des vérifications de données pour vous aider à identifier de potentiels problèmes de données courants. Chaque vérification ou visualisation inclut une déclaration décrivant le problème de données et les éléments exploitables correspondants.
Les résultats sont classés dans l'un des trois niveaux de gravité suivants :
- ERROR : identifie les problèmes de données extrêmement graves qui empêcheront très probablement la convergence du modèle. Des seuils par défaut stricts sont utilisés pour l'état
ERRORafin de s'assurer que seules les erreurs les plus extrêmes (qui sont généralement des erreurs d'entrée des données) sont signalées. L'échantillonnage a posteriori est bloqué tant que vous n'avez pas résolu ces problèmes. - ATTENTION : identifie les problèmes potentiels importants liés aux données. Bien que ces problèmes n'empêchent pas strictement la convergence du modèle, ils indiquent clairement des éléments que vous devriez examiner et éventuellement corriger. Étant donné que certains cas d'utilisation peuvent tout de même justifier l'exécution du modèle, Meridian autorise l'échantillonnage a posteriori. Toutefois, vous devez appliquer votre contexte métier pour déterminer s'il est approprié de continuer avec vos données actuelles.
- INFO : indique qu'aucun état
ERRORouATTENTIONn'a été déclenché, ou met en évidence des vérifications pour lesquelles aucun seuil n'est défini. Bien que vous puissiez raisonnablement vous attendre à ajuster un modèle utile dans ces conditions, vous devez toujours examiner les métriques et visualisations associées au niveauINFOpour identifier d'éventuelles anomalies ou incohérences dans les données sous-jacentes.
Le résultat HTML de l'analyse exploratoire des données organise les problèmes de données en cinq catégories :
- Dépenses et unité média : analyse la part des dépenses au niveau du canal et compare les dépenses aux unités média.
- Variables explicatives ou de réponse individuelles : examine la variabilité des variables individuelles, en signalant les problèmes tels qu'un écart-type nul (absence de variation) ou des anomalies extrêmes.
- Mise à l'échelle de la population des variables explicatives : évalue la relation entre la population et les variables explicatives.
- Relation entre les variables : explore les corrélations entre les variables, ainsi que les relations entre les variables explicatives et les principaux effets temporels ou géographiques.
- Spécifications a priori : évalue les spécifications a priori, en particulier la probabilité a priori d'une référence négative.
Configuration et génération de rapports
Suivez les étapes ci-dessous pour générer le rapport HTML de l'analyse exploratoire des données ou exécuter les vérifications de données individuelles décrites dans ce document.
Commencez par instancier le modèle
Meridianet l'objetMeridianEDA. Exécutez le code de configuration suivant une seule fois :from meridian.model import model from meridian.model.eda import meridian_eda mmm = model.Meridian(...) mmm_eda = meridian_eda.MeridianEDA(mmm)Remarque : Les extraits de code suivants de cette page omettent cette configuration et n'affichent que les appels de méthode spécifiques à l'aide de l'objet
mmm_eda.Une fois la configuration terminée, exécutez le code suivant pour générer et enregistrer le rapport HTML complet de l'analyse exploratoire des données :
import IPython

mmm_eda.generate_and_save_report(
    filename=your_filename, filepath=your_filepath
)
IPython.display.HTML(filename=f'{your_filepath}{your_filename}')
Catégorie 1 : Dépenses et unité média
Cette catégorie analyse la part des dépenses au niveau du canal et compare les dépenses aux unités média.
Part des dépenses
Exemple de résultat :
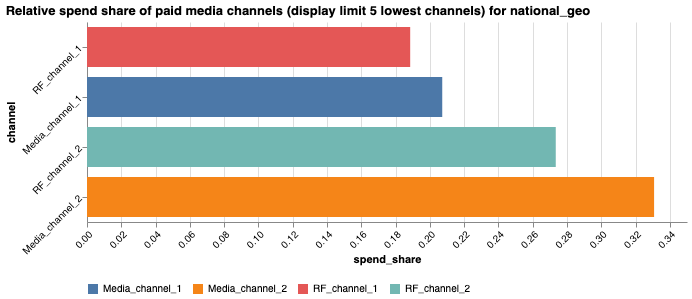
Le graphique à barres du rapport HTML affiche le pourcentage des dépenses au niveau national (agrégées pour les zones géographiques dans les modèles au niveau géographique) pour chaque canal média et chaque canal avec couverture et fréquence pour les cinq canaux les moins dépensiers.
Examinez la part de chaque canal dans les dépenses totales. Il peut être difficile d'estimer les canaux dont la part des dépenses est très faible. Envisagez de les combiner avec d'autres canaux.
Vous pouvez également représenter la part des dépenses pour des zones géographiques spécifiques et pour un nombre donné de canaux ayant la part des dépenses la plus faible :
mmm_eda.plot_relative_spend_share_barchart(
    geos=<list_of_geos>, n_channels=<your_integer_choice>
)
Ratio données/paramètres
Après avoir examiné la répartition des parts de dépenses, évaluez le ratio entre les points de données et les paramètres du modèle. Ce ratio constitue une indication approximative de la quantité de données nécessaire pour estimer de manière fiable les paramètres du modèle. La façon la plus précise d'évaluer ce ratio est d'exécuter le modèle et d'évaluer la largeur des intervalles crédibles.
Le ratio est défini comme n_data_points/n_parameters, où :
n_data_points=n_geos*n_timesn_parameters=n_geos- 1 +n_knots+n_controls+n_treatments
Ce calcul utilise les composants suivants :
n_geos: nombre de zones géographiques dans l'ensemble de données. Nous en soustrayons une pour la zone géographique de référence.n_times: nombre de périodes.n_knots: nombre de nœuds spécifiés à l'aide de l'argumentknotsdansModelSpec.n_controls: nombre de variables de contrôle.n_treatments: nombre total de variables de traitement, y compris les médias payants, les médias naturels, la couverture et la fréquence payantes, la couverture et la fréquence naturelles, et les traitements non média.
Ce calcul exclut les paramètres géographiques distincts pour n_treatments et n_controls. Dans le modèle hiérarchique de Meridian, les effets au niveau géographique ne sont pas indépendants. Le partage d'informations entre les zones géographiques réduit considérablement le nombre effectif de paramètres. Le nombre au niveau national sert de référence pratique et indulgente. Pour une comparaison avec une vue stricte qui ne suppose aucun pooling, consultez la section Quantité de données requise.
Un ratio très faible peut indiquer que les données sont insuffisantes pour l'estimation, ce qui entraîne une variance élevée et des calculs peu fiables. Si cela se produit, envisagez d'abandonner ou de combiner des canaux, ou de réduire le nombre de nœuds à l'aide de l'argument knots dans ModelSpec. Lorsque vous choisissez les canaux à modifier, utilisez les insights obtenus dans la sous-section Part de dépenses pour identifier ceux dont les dépenses sont les plus faibles.
Pour en savoir plus sur les exigences concernant les données et les nuances de la modélisation hiérarchique géographique, consultez Quantité de données requise.
Dépenses, unité média et coût par unité média
Pour les canaux média et les canaux avec couverture et fréquence, des vérifications croisées sont effectuées sur les dépenses, les unités média et le coût par unité média. Les unités média analysées ici sont des unités média brutes (non mises à l'échelle). Pour les canaux avec couverture et fréquence, les unités média sont des impressions avec couverture et fréquence, calculées comme le produit entre couverture brute (non mise à l'échelle) et fréquence.
Ces vérifications croisées permettent d'identifier les incohérences entre les données de dépenses et d'unités média, par exemple des dépenses nulles avec des unités média positives, ou des dépenses positives avec des unités média nulles. Si des incohérences sont détectées, l'état ATTENTION est signalé.
Examinez les données entrées pour ces canaux médias payants signalés et leurs dépenses.
Cette vérification signale également un état ATTENTION s'il existe des anomalies dans le coût par unité média (calculé en divisant les dépenses par les unités média). Le package AED de Meridian définit une anomalie à l'aide de la règle empirique de l'écart interquartile (IQR) : valeurs inférieures à Q1 - 1,5 * IQR ou supérieures à Q3 + 1,5 * IQR. Le tableau HTML affiche les valeurs absolues du coût par unité média pour les cinq anomalies les plus extrêmes, classées par ordre décroissant. Vérifiez si ces canaux présentent des erreurs potentielles d'entrée des données.
Vous pouvez exécuter le code suivant pour récupérer le coût par unité média calculé pour tous les canaux média et canaux avec couverture et fréquence à chaque période (et pour chaque zone géographique dans les modèles géographiques) :
# For geo models
[geo_cpm] = mmm_eda.geo_cost_per_media_unit_check_outcome.get_geo_artifacts()
geo_cpm.cost_per_media_unit_da

# For national models
[national_cpm] = (
    mmm_eda.national_cost_per_media_unit_check_outcome
    .get_national_artifacts()
)
national_cpm.cost_per_media_unit_da
Le rapport HTML comprend également deux graphiques de série temporelle pour les canaux signalés avec un état ATTENTION (pour les incohérences ou les anomalies). Le premier graphique superpose la série temporelle des dépenses au niveau du canal avec la série temporelle des unités média. Le deuxième graphique montre la série temporelle du coût par unité média au niveau du canal. Chaque graphique de série temporelle correspond à un canal.
Ces graphiques de série temporelle HTML sont basés sur les quantités au niveau national. Pour les ensembles de données au niveau géographique, le coût et les unités média de chaque canal sont agrégés au niveau national avant de calculer le ratio du coût par unité média. Si aucun état ATTENTION n'est signalé, ces graphiques n'apparaîtront pas dans le rapport HTML de l'analyse exploratoire des données.
Exemple de résultat :

Vous pouvez représenter la série temporelle des dépenses, des unités média et du coût par unité média pour des canaux et des zones géographiques spécifiques afin de vous concentrer sur un sous-ensemble de vos données :
mmm_eda.plot_cost_per_media_unit_time_series(
    geos=<list_of_geos>, channels=<list_of_channels>
)
Remarque : Si les données de dépenses de l'utilisateur ne comportent pas de dimensions temporelles ou géographiques, elles sont automatiquement réparties entre ces dimensions en fonction des unités média. Cela entraîne un coût constant par unité média, et aucune incohérence ne se produit entre les dépenses et les unités média. Par conséquent, ces vérifications de données spécifiques seront toujours réussies.
Catégorie 2 : Variables explicatives ou de réponse individuelles
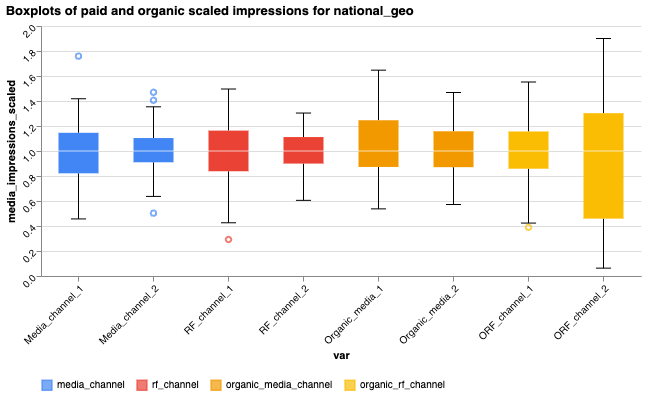
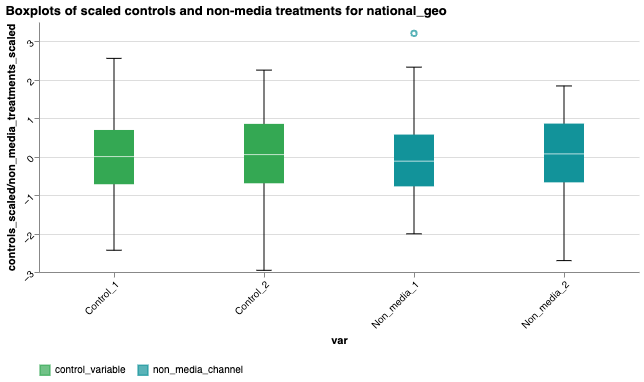
Nous illustrons la variation de chaque variable avec des graphiques en boîte.
Les graphiques regroupent les variables suivantes :
- Impressions mises à l'échelle (vues naturelles et payantes) : elles sont affichées ensemble dans un graphique, car elles subissent les mêmes transformations qui sont détaillées dans la documentation sur les données d'entrée. Cela comprend les impressions avec couverture et fréquence mises à l'échelle pour les canaux avec couverture et fréquence et les canaux naturels avec couverture et fréquence, où les impressions avec couverture et fréquence mises à l'échelle sont calculées en multipliant la couverture mise à l'échelle par la fréquence.
- Contrôles et traitements non média mis à l'échelle : ils sont affichés ensemble dans un graphique distinct, car ces variables sont transformées de manière similaire.
- KPI mis à l'échelle : ils sont affichés dans leur propre graphique en boîte.
Pour les ensembles de données au niveau géographique, le package AED de Meridian agrège d'abord les variables brutes (non mises à l'échelle) au niveau national, puis transforme les variables conformément à la documentation sur les données d'entrée, et enfin trace les graphiques en boîte.
Examinez la variabilité des variables explicatives et des variables de réponse affichées dans les graphiques en boîte. Les variables explicatives présentant une très faible variabilité peuvent être difficiles à estimer et peuvent entraver la convergence du modèle. Envisagez de les fusionner ou de les remplacer, de supprimer les variables négligeables ou d'utiliser un a priori personnalisé si vous disposez d'informations pertinentes. Si des anomalies sont présentes, vérifiez vos données d'entrée pour vous assurer qu'elles sont authentiques et correctes.
Exemple de résultat :
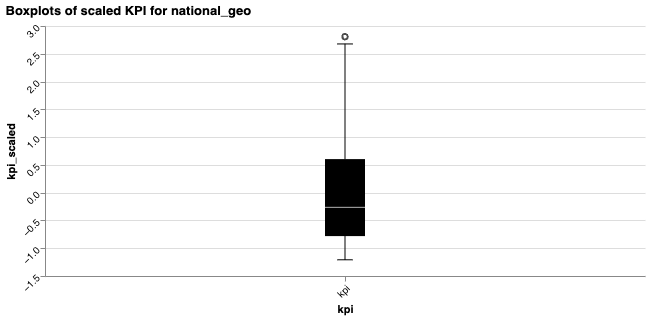
Vous pouvez tracer des graphiques en boîte pour des zones géographiques spécifiques :
# For paid and organic scaled impressions
mmm_eda.plot_treatments_without_non_media_boxplot(geos=<list_of_geos>)

# For controls and non-media treatments
mmm_eda.plot_controls_and_non_media_boxplot(geos=<list_of_geos>)

# For KPI
mmm_eda.plot_kpi_boxplot(geos=<list_of_geos>)
Manque critique de variation
L'écart-type du KPI transformé est calculé pour toutes les zones géographiques et périodes pour un modèle géographique, ou pour toutes les périodes pour un modèle national. Un état ERROR est déclenché lorsque le KPI transformé est presque totalement constant, ce qui est indiqué par un écart-type inférieur à 1e-4. Cela signifie qu'il n'y a aucun signal dans la variable de réponse. Vous devez vérifier si des erreurs d'entrée des données se sont produites ou reconsidérer la faisabilité de la modélisation statistique avec cet ensemble de données.
Pour les variables explicatives, Meridian calcule d'abord séparément l'écart-type des contrôles mis à l'échelle et des variables de traitement mises à l'échelle (y compris la couverture mise à l'échelle pour les canaux avec couverture et fréquence et les canaux naturels avec couverture et fréquence) selon la dimension temporelle et la dimension géographique (le cas échéant).
- Variation selon la zone géographique : l'écart-type des variables mises à l'échelle selon la dimension géographique n'est évalué que pour les ensembles de données au niveau géographique, car un modèle national ne comporte qu'une seule zone géographique. Un état
ERRORse produit lorsque vous avez définiknots = n_timeset qu'une variable ne varie pas selon les zones géographiques (par exemple, une variable au niveau national dans un ensemble de données au niveau géographique). Lorsqueknots = n_times, chaque période dispose de son propre paramètre de nœud. Étant donné qu'une variable au niveau national ne varie que dans le temps et non en fonction des zones géographiques, elle est parfaitement colinéaire avec le temps et redondante dans un modèle à nœuds complets. Pour résoudre cette redondance, vous pouvez (1) conserver la variable au niveau national et définirknots < n_times, ou (2) supprimer les variables qui ne varient pas selon les zones géographiques. Le choix dépend de vos objectifs d'interprétation spécifiques. - Variation dans le temps : pour un modèle géographique, un état
ERRORse produit lorsqu'une variable ne varie pas dans le temps, car elle devient parfaitement colinéaire avec l'effet géographique principal $\tau_g$. Comme cette variable redondante entraîne une mauvaise convergence du modèle, vous devez supprimer toute variable qui ne varie pas dans le temps. Pour un modèle national, une variable qui ne varie pas dans le temps agit comme un terme constant qui ne fournit aucun signal et nuit à la convergence du modèle. Un étatERRORse produit, et vous devez supprimer cette variable constante du modèle.
Anomalies et parcimonie potentielle des données
Le package AED de Meridian recherche également les anomalies dans chaque traitement mis à l'échelle, chaque variable de contrôle mise à l'échelle et chaque KPI mis à l'échelle à l'aide de la règle empirique standard de l'intervalle interquartile (IQR) (cette vérification se produit au niveau géographique pour les ensembles de données au niveau géographique).
Si des anomalies sont présentes, cette vérification signale un état ATTENTION et affiche dans le rapport HTML AED les cinq anomalies les plus extrêmes (en fonction de la valeur absolue).
Vous devez vérifier vos données d'entrée pour vous assurer que ces valeurs sont authentiques et correctes.
Indépendamment du signalement des anomalies, cette vérification évalue également la potentielle parcimonie des données en calculant l'écart-type de chaque variable avec et sans ces anomalies. Si l'écart-type tombe à zéro après la suppression des anomalies (ce qui signifie que la variable ne présente de variation qu'en raison des
anomalies), cette vérification signale un état ATTENTION supplémentaire.
- Si les variables de traitement ou de contrôle affichent un écart-type nul après la suppression des anomalies, cela peut indiquer une parcimonie des données. Bien que cela puisse être intentionnel (par exemple, parcimonie des données en raison de périodes "go-dark (suppression)"), cela peut avoir un impact sur la convergence et le caractère identifiable du modèle. Vérifiez si cela est intentionnel. Si ce n'est pas le cas, envisagez de regrouper ces variables pour améliorer la stabilité du modèle.
- Si le KPI présente un écart-type nul dans certaines zones géographiques après la suppression des anomalies, cela indique un signal faible ou inexistant dans la variable de réponse pour ces zones. Examinez les données d'entrée ou envisagez de regrouper ces zones géographiques.
Vous pouvez récupérer les écarts-types pour chaque variable (calculés pour des zones géographiques spécifiques dans les modèles géographiques) et les mapper dans un dictionnaire pour faciliter l'accès à l'aide du code suivant :
# For geo models
geo_std = mmm_eda.geo_stdev_check_outcome.analysis_artifacts
geo_std_dict = {a.variable: a.std_ds for a in geo_std}

# For national models
national_std = mmm_eda.national_stdev_check_outcome.analysis_artifacts
national_std_dict = {a.variable: a.std_ds for a in national_std}
Catégorie 3 : Mise à l'échelle de la population des variables explicatives
Cette catégorie ne s'applique qu'aux ensembles de données au niveau géographique. Pour les ensembles de données au niveau national, la zone géographique unique (nationale) est traitée comme ayant une population nominale de 1,0, et les valeurs de population n'affectent pas le modèle, car la mise à l'échelle interne de Meridian (mise à l'échelle médiane ou standardisation) annule l'effet de la population nationale.
Corrélation entre la population et les variables média naturel ou média payant brutes
Cette vérification évalue la corrélation de Spearman entre la population géographique et les variables média payant ou média naturel brutes. Ces variables incluent les unités média brutes, la couverture brute (pour les canaux avec couverture et fréquence), les unités média naturel brutes et la couverture naturelle brute (pour les canaux avec couverture et fréquence naturelles). Nous évaluons ici la corrélation de Spearman pour apprécier la relation loglinéaire entre la population et ces variables.
Vous devriez obtenir des valeurs de corrélation de Spearman positives pour ces variables. Si vous observez une corrélation faible ou négative, vérifiez vos données d'entrée. Le package AED de Meridian attribue uniquement le libellé INFO à ces vérifications, sans déclencher les états ERROR ni ATTENTION. Toutefois, il est fortement recommandé de vérifier les valeurs.
Exemple de résultat :
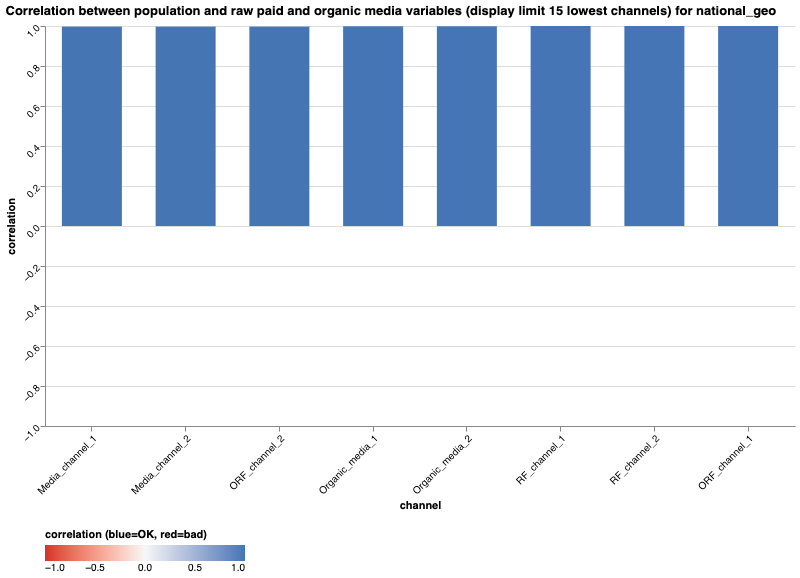
Vous pouvez récupérer les valeurs de corrélation pour chacune des variables mentionnées précédemment à l'aide du code suivant :
[pop_corr_raw] = (
    mmm_eda.eda_engine.check_population_corr_raw_media()
    .get_overall_artifacts()
)
pop_corr_raw.correlation_ds
Corrélation entre la population et les traitements et contrôles mis à l'échelle
Ici, les traitements et contrôles mis à l'échelle font référence aux quantités transformées, conformément à la documentation sur les données d'entrée. Pour les traitements et contrôles non média, ils dépendent également des arguments non_media_population_scaling_id et control_population_scaling_id dans ModelSpec, respectivement. Examinez la corrélation de Spearman entre la population et les unités de traitement mises à l'échelle ou les variables de contrôle mises à l'échelle.
- Contrôles et canaux non média : Meridian ne met pas à l'échelle de la population ces variables par défaut. Une corrélation élevée indique que vous devriez probablement appliquer une mise à l'échelle de la population à l'aide des arguments
control_population_scaling_idounon_media_population_scaling_iddansModelSpec. Pour en savoir plus, consultez Mise à l'échelle de la population des variables de contrôle. - Canaux média payants et naturels : Meridian met automatiquement à l'échelle de la population ces canaux par défaut. Une corrélation élevée suggère ici que la variable a peut-être déjà été mise à l'échelle de la population avant d'être transmise à Meridian. Vérifiez votre pipeline de données d'entrée.
Comme pour la vérification précédente, elle est signalée avec l'état INFO uniquement, mais vous devez examiner les valeurs.
Exemple de résultat :
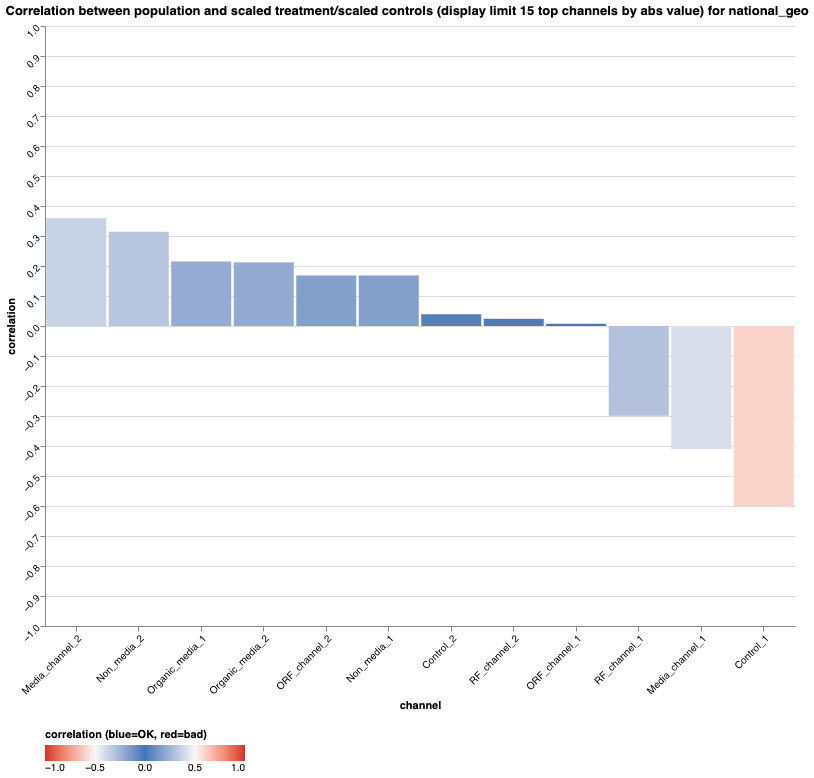
Vous pouvez récupérer les valeurs de corrélation à l'aide du code suivant :
[pop_corr_scaled] = (
    mmm_eda.eda_engine.check_population_corr_scaled_treatment_control()
    .get_overall_artifacts()
)
pop_corr_scaled.correlation_ds
Catégorie 4 : Relation entre les variables
Cette catégorie explore les corrélations entre les variables, ainsi que les relations entre les variables explicatives et les principaux effets temporels ou géographiques.
Carte de densité de corrélation
Une corrélation par paire élevée entre des variables peut entraîner des problèmes d'identification et de convergence du modèle. Si vous observez une corrélation élevée, envisagez de combiner les variables concernées.
Exemple de résultat :
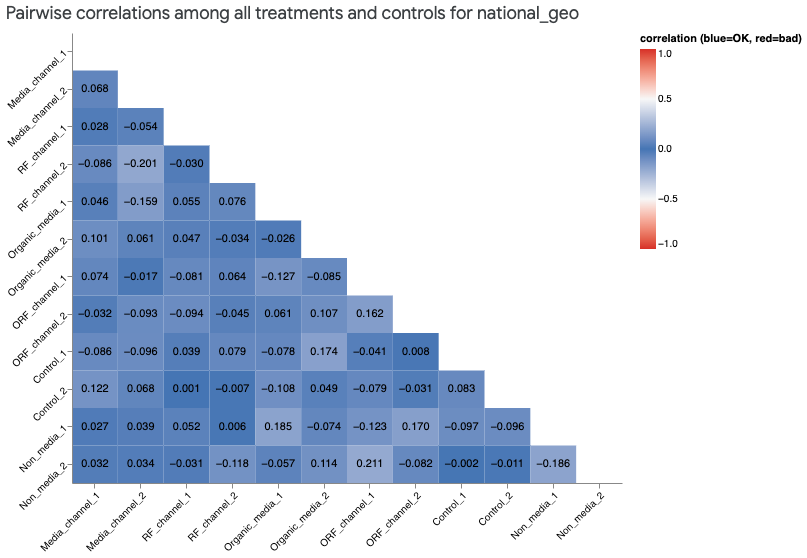
La carte de densité illustre la corrélation de Pearson entre les traitements mis à l'échelle et les variables de contrôle mises à l'échelle. Les traitements mis à l'échelle incluent les impressions avec couverture et fréquence mises à l'échelle pour les canaux avec couverture et fréquence et les canaux naturels avec couverture et fréquence. Ici, les traitements et contrôles mis à l'échelle font référence aux quantités transformées, conformément à la documentation sur les données d'entrée. La carte de densité HTML affiche les corrélations en fonction de variables mises à l'échelle au niveau national. Pour les ensembles de données au niveau géographique, les variables (non mises à l'échelle) brutes sont agrégées au niveau national, puis transformées, et leur corrélation par paire est ensuite calculée.
Vous pouvez utiliser le code suivant pour représenter la carte de densité de corrélation pour une zone géographique spécifique :
mmm_eda.plot_pairwise_correlation(geos=<list_of_geos>)
Multicolinéarité à l'aide de la vérification du facteur d'inflation de la variance (FIV)
Pour évaluer plus précisément la multicolinéarité, le facteur d'inflation de la variance (FIV) est calculé pour toutes les unités de traitement mises à l'échelle et les variables de contrôle mises à l'échelle. Le FIV estime dans quelle mesure la variance d'une variable de traitement ou de contrôle est gonflée en raison de la colinéarité avec d'autres traitements ou contrôles. Un FIV de 1 indique l'absence de colinéarité, tandis que des valeurs plus élevées suggèrent une multicolinéarité croissante. Une corrélation parfaite par paire est une cause fréquente de multicolinéarité. Une multicolinéarité élevée élargit les intervalles crédibles des coefficients, ce qui rend l'inférence a posteriori moins fiable.
Selon le type de modèle, la vérification du FIV évalue les données et déclenche les états suivants :
État
ERRORdu modèle géographique : pour les modèles géographiques, le FIV est calculé pour toutes les zones géographiques et toutes les périodes. Plus précisément, les valeurs de chaque variable pour toutes les zones géographiques et toutes les périodes sont aplaties dans un seul tableau, puis le FIV est calculé pour chacun de ces tableaux aplatis. Un étatERRORest déclenché si une variable peut être exprimée presque parfaitement comme une combinaison linéaire d'autres variables, ce qui est démontré par un FIV dépassant le seuil global par défaut de 1 000. Pour résoudre ce problème, supprimez les variables qui sont des combinaisons linéaires d'autres variables ou envisagez de les combiner.Vous pouvez récupérer les FIV globaux du modèle géographique (calculés pour toutes les zones géographiques et toutes les périodes) à l'aide du code suivant :
[overall_vif] = mmm_eda.eda_engine.check_geo_vif().get_overall_artifacts()
overall_vif.vif_da
État
ERRORdu modèle national : pour les modèles nationaux, le FIV est calculé pour toutes les périodes, car il n'y a qu'une seule zone géographique. Un étatERRORest déclenché si le FIV d'une variable dépasse le seuil national par défaut de 1 000. Pour résoudre ce problème, supprimez les variables qui sont des combinaisons linéaires d'autres variables ou envisagez de les combiner.Vous pouvez récupérer les FIV calculés pour le modèle national à l'aide du code suivant :
[national_vif] = mmm_eda.eda_engine.check_national_vif().get_national_artifacts()
national_vif.vif_da
État
ATTENTIONdu modèle géographique : pour les modèles géographiques, le FIV est également calculé pour toutes les périodes de chaque zone géographique spécifique. Un étatATTENTIONest généré si les variables dépassent le seuil géographique par défaut de 1 000 dans des zones géographiques individuelles. Pour résoudre ce problème, vérifiez les données ou combinez ces variables, en particulier si elles présentent un FIV élevé dans plusieurs zones géographiques.Vous pouvez récupérer les FIV du modèle géographique pour des zones géographiques individuelles à l'aide du code suivant :
[geo_vif] = mmm_eda.eda_engine.check_geo_vif().get_geo_artifacts()
geo_vif.vif_da
Vous pouvez ajuster ces seuils extrêmes si nécessaire. Pour en savoir plus sur la définition de ces seuils, consultez Seuil de FIV personnalisé.
Lorsque l'un de ces états ERROR ou ATTENTION est déclenché, le rapport HTML présente sous forme de tableau les cinq premières variables ayant le FIV le plus élevé et liste les autres variables avec lesquelles elles sont fortement corrélées.
Colinéarité avec l'effet géographique principal $\tau_g$
Cette vérification régresse chaque variable par rapport à la zone géographique en tant que variable catégorielle. Dans ce cas, un coefficient de détermination élevé indique la faible variation temporelle d'une variable. Cela peut entraîner un modèle faiblement identifiable et non convergent en raison des effets géographiques principaux.
Envisagez de supprimer la variable ayant un coefficient de détermination très élevé. Le rapport HTML présente sous forme de tableau les cinq variables ayant les coefficients de détermination les plus élevés.
Cette vérification est de niveau INFO (sans seuils pour signaler un état ERROR ou ATTENTION), mais nous vous recommandons d'examiner le tableau.
Colinéarité avec l'effet temporel principal $\mu_t$
Cette vérification régresse chaque variable par rapport à la période en tant que variable catégorielle. Un coefficient de détermination élevé indique la faible variation géographique d'une variable. Cela peut entraîner un modèle faiblement identifiable et non convergent si un grand nombre de nœuds sont utilisés.
Envisagez de supprimer la variable avec un coefficient de détermination très élevé ou de réduire l'argument knots dans ModelSpec. Le rapport HTML présente sous forme de tableau les cinq variables avec les valeurs de coefficient de détermination les plus élevées. Cette vérification est de niveau INFO (aucun seuil pour signaler un état ERROR ou ATTENTION), mais nous vous recommandons d'examiner le tableau.
Vous pouvez récupérer les valeurs de coefficient de détermination calculées pour toutes les variables (par zone géographique et période) à l'aide du code suivant :
[mmm_geo_time_collinearity] = (
    mmm_eda.eda_engine.check_variable_geo_time_collinearity()
    .get_overall_artifacts()
)
mmm_geo_time_collinearity.rsquared_ds
Catégorie 5 : Spécifications a priori
Cette catégorie évalue les spécifications a priori, en particulier la probabilité a priori d'une référence négative. Une référence négative équivaut à des effets de traitement qui reçoivent trop de crédit. Examinez la probabilité a priori de référence négative ainsi que le graphique à barres pour la moyenne a priori de la contribution au niveau du canal. Si la probabilité a priori de référence négative est élevée, envisagez d'utiliser des a priori de traitement personnalisés. En particulier, un type d'a priori contribution personnalisé peut être approprié.
Exemple de résultat :
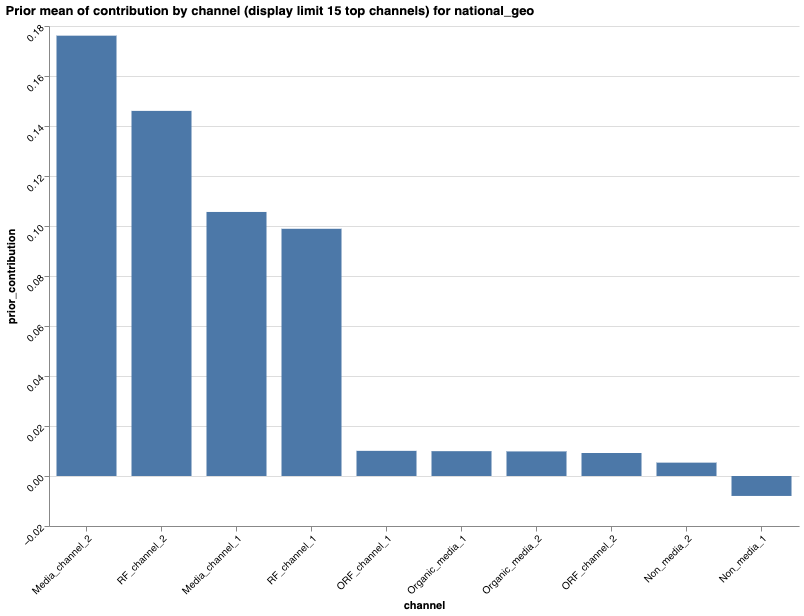
Le graphique n'affiche que les 15 premiers canaux. Vous pouvez obtenir la probabilité a priori d'une référence négative et la moyenne a priori de la contribution au niveau du canal à l'aide du code suivant :
[prior_check] = mmm_eda.eda_engine.check_prior_probability().get_overall_artifacts()

# This returns the prior probability of negative baseline
prior_check.prior_negative_baseline_prob

# This returns the channel-level prior mean of contribution
prior_check.mean_prior_contribution_da
Vérifications, visualisations et personnalisations supplémentaires
Au-delà du rapport HTML, vous pouvez explorer des diagnostics de données supplémentaires et des configurations personnalisées pour adapter le processus AED.
Série temporelle des KPI avec des nœuds
Vous pouvez visualiser la série temporelle des KPI au niveau national superposée aux nœuds spécifiés dans votre ModelSpec :
mmm_eda.plot_national_kpi_with_knots_time_series()
Exemple de résultat :

Les nœuds affichés dépendent de la configuration de l'argument knots dans ModelSpec :
- Paramètre par défaut : Meridian utilise des nœuds complets pour les ensembles de données au niveau géographique, tandis qu'un seul nœud est défini par défaut pour les modèles nationaux (le graphique est omis s'il n'y a qu'un seul nœud).
- Algorithme AKS : si
enable_aks = True, cette fonction représente les nœuds sélectionnés par la méthode Automatic Knot Selection (AKS). - Spécification manuelle : représente les emplacements des nœuds que vous avez définis manuellement.
Ce graphique de série temporelle des KPI avec des nœuds est une visualisation utile pour vous aider à évaluer l'emplacement de vos nœuds et à déterminer si vous devez ajouter ou supprimer manuellement des nœuds. Pour obtenir plus de conseils, consultez Définir des nœuds.
Vérification de la corrélation par paire
Le package AED de Meridian calcule la corrélation par paire de Pearson entre toutes les unités de traitement mises à l'échelle et variables de contrôle mises à l'échelle.
État du modèle géographique
ERROR: pour les modèles géographiques, la corrélation par paire est d'abord calculée pour toutes les zones géographiques et toutes les périodes. Plus précisément, les valeurs de chaque variable pour toutes les zones géographiques et périodes sont aplaties dans un seul tableau, et la corrélation par paire est calculée entre ces tableaux aplatis. Un étatERRORest déclenché si une paire de variables présente une corrélation presque parfaite pour toutes les zones géographiques et périodes (la valeur absolue de leur corrélation par paire dépassant le seuil par défaut de 0,999). Pour résoudre ce problème, supprimez l'une des variables redondantes des données d'entrée.Vous pouvez récupérer la corrélation par paire globale du modèle géographique (calculée pour toutes les zones géographiques et périodes) à l'aide du code suivant :
[overall_corr] = mmm_eda.eda_engine.check_geo_pairwise_corr().get_overall_artifacts()
overall_corr.corr_matrix
État
ERRORdu modèle national : pour les modèles nationaux, la corrélation par paire est calculée pour toutes les périodes, car il n'y a qu'une seule zone géographique. Un étatERRORest déclenché si la valeur absolue de la corrélation par paire entre une paire de variables dépasse le seuil par défaut de 0,999. Pour résoudre ce problème, supprimez l'une des variables redondantes des données d'entrée.Vous pouvez récupérer la corrélation par paire calculée pour le modèle national à l'aide du code suivant :
[national_corr] = mmm_eda.eda_engine.check_national_pairwise_corr().get_national_artifacts()
national_corr.corr_matrix
État
ATTENTIONdu modèle géographique : pour les modèles géographiques, la corrélation par paire est également calculée pour toutes les périodes pour chaque zone géographique spécifique. Un étatATTENTIONest généré si une paire de variables présente une corrélation presque parfaite dans des zones géographiques individuelles, dépassant le seuil par défaut de 0,999. Pour résoudre ce problème, vérifiez les données ou envisagez de combiner ces variables si elles présentent également une forte corrélation par paire dans plusieurs zones géographiques.Vous pouvez récupérer les corrélations par paire du modèle géographique pour des zones géographiques individuelles à l'aide du code suivant :
[geo_corr] = mmm_eda.eda_engine.check_geo_pairwise_corr().get_geo_artifacts()
geo_corr.corr_matrix
Vous pouvez ajuster ces seuils extrêmes si nécessaire. Pour en savoir plus sur la définition de ces seuils, consultez Seuil de corrélation par paire personnalisé.
Personnalisations configurables par l'utilisateur
Le package AED de Meridian propose plusieurs options de configuration pour adapter le processus d'analyse exploratoire des données à votre ensemble de données et vos besoins de modélisation spécifiques.
Méthode d'agrégation personnalisée du niveau géographique au niveau national
Pour effectuer une analyse exploratoire des données au niveau national sur un ensemble de données au niveau géographique, le package AED de Meridian agrège en interne les données brutes au niveau géographique (non mises à l'échelle) dans le niveau national avant d'appliquer les transformations. Cela assure l'équivalence avec le cas où les utilisateurs doivent d'abord agréger manuellement leur propre ensemble de données au niveau géographique dans le niveau national, puis transmettre ces données au niveau national à Meridian et appliquer l'analyse exploratoire des données.
Par défaut, les unités média brutes, unités média naturelles brutes, couverture brute et KPI brut sont additionnés pour toutes les zones géographiques. Pour agréger la fréquence, le package AED de Meridian calcule les impressions brutes avec couverture et fréquence (couverture multipliée par la fréquence) pour chaque zone géographique, additionne les impressions avec couverture et fréquence et la couverture pour toutes les zones géographiques, et divise le nombre total d'impressions avec couverture et fréquence au niveau national par la couverture totale au niveau national. Des calculs similaires s'appliquent lorsque vous cumulez la fréquence naturelle.
Bien que l'agrégation SUM par défaut soit appropriée pour la plupart des variables, vous pouvez définir une méthode d'agrégation personnalisée pour des variables de contrôle ou des traitements non média spécifiques. Cela est particulièrement utile pour les variables qui sont binaires, ou qui représentent des taux ou des pourcentages.
Par exemple, si vous souhaitez calculer la moyenne d'une variable de contrôle nommée rating pour toutes les zones géographiques :
from meridian.model import model
from meridian.model.eda import eda_spec
import numpy as np

mmm_agg_config = eda_spec.AggregationConfig(
    control_variables={'rating': np.mean}
)
mmm_eda_spec = eda_spec.EDASpec(aggregation_config=mmm_agg_config)
mmm = model.Meridian(..., eda_spec=mmm_eda_spec)
Seuil de FIV personnalisé
Le package AED de Meridian déclenche un état ERROR ou ATTENTION pour les problèmes de données extrêmes, tels que la multicolinéarité quasi parfaite. Pour éviter l'instabilité numérique tout en conservant la flexibilité, le package utilise un seuil de FIV extrême par défaut de 1 000 au lieu de l'infini. Vous pouvez calibrer ces seuils en fonction de votre contexte métier et de votre jugement :
geo_threshold: pour les ensembles de données au niveau géographique. Si le FIV d'une variable dans une zone géographique spécifique dépasse cette valeur, l'étatATTENTIONest déclenché. L'échantillonnage a posteriori peut toujours avoir lieu.overall_threshold: pour les ensembles de données au niveau géographique. Si le FIV d'une variable (calculé pour toutes les zones géographiques et périodes) dépasse cette valeur, l'étatERRORest déclenché. L'échantillonnage a posteriori est bloqué.national_threshold: pour les ensembles de données au niveau national. Si le FIV d'une variable dépasse cette valeur, l'étatERRORest déclenché. L'échantillonnage a posteriori est bloqué.
Par exemple, pour abaisser le overall_threshold de multicolinéarité de 1 000 à 50 :
from meridian.model import model
from meridian.model.eda import eda_spec

mmm_custom_vif = eda_spec.VIFSpec(overall_threshold=50)
mmm_eda_spec = eda_spec.EDASpec(vif_spec=mmm_custom_vif)
mmm = model.Meridian(..., eda_spec=mmm_eda_spec)
Seuil de corrélation par paire personnalisé
Un état ERROR ou ATTENTION est également déclenché en cas de corrélation par paire extrême. Le seuil de corrélation extrême par défaut est défini sur 0,999. Vous pouvez calibrer ces seuils en fonction de votre ensemble de données spécifique et de votre jugement :
geo_threshold: pour les ensembles de données au niveau géographique. Si la valeur absolue de la corrélation par paire entre deux variables dans une zone géographique spécifique dépasse cette valeur, l'étatATTENTIONest déclenché. L'échantillonnage a posteriori peut tout de même avoir lieu.overall_threshold: pour les ensembles de données au niveau géographique. Si la valeur absolue de la corrélation par paire (calculée pour toutes les zones géographiques et périodes) dépasse cette valeur, l'étatERRORest déclenché. L'échantillonnage a posteriori est bloqué.national_threshold: pour les ensembles de données au niveau national. Si la valeur absolue de la corrélation par paire dépasse cette valeur, l'étatERRORest déclenché. L'échantillonnage a posteriori est bloqué.
Par exemple, pour réduire le overall_threshold de la corrélation par paire d'un modèle géographique de 0,999 à 0,95 :
from meridian.model import model
from meridian.model.eda import eda_spec

mmm_custom_corr = eda_spec.PairwiseCorrSpec(overall_threshold=0.95)
mmm_eda_spec = eda_spec.EDASpec(pairwise_corr_spec=mmm_custom_corr)
mmm = model.Meridian(..., eda_spec=mmm_eda_spec)
Autres personnalisations
Le package AED de Meridian permet d'utiliser d'autres seuils personnalisables dans la valeur EDASpec.
Ces valeurs par défaut servent de garde-fous internes pour ce que le package considère comme des variables constantes. Il est rare que vous ayez besoin d'ajuster ces valeurs par défaut, mais elles sont
disponibles pour vos propres cas particuliers.
Personnaliser
KpiInvariabilitySpec: comme indiqué dans Manque critique de variation, le package AED de Meridian déclenche un étatERRORet bloque l'échantillonnage a posteriori lorsque le KPI transformé présente un écart-type global inférieur au seuil par défaut de 1e-4. Vous pouvez utiliser la valeurKpiInvariabilitySpecpour ajuster lestd_thresholdqui détermine quand un KPI à faible variabilité déclenche cet étatERROR.Par exemple, pour abaisser ce
std_thresholddans la valeurKpiInvariabilitySpecà 1e-5 :from meridian.model import model from meridian.model.eda import eda_spec custom_kpi_spec = eda_spec.KpiInvariabilitySpec(std_threshold=1e-5) mmm_eda_spec = eda_spec.EDASpec(kpi_invariability_spec=custom_kpi_spec) mmm = model.Meridian(..., eda_spec=mmm_eda_spec)Personnaliser
StandardDeviationSpec: comme indiqué dans Anomalies et parcimonie potentielle des données, les variables dont l'écart-type est extrêmement faible (calculé après la suppression des anomalies) indiquent une parcimonie potentielle des données ou un manque de signal. Vous pouvez utiliser la valeurStandardDeviationSpecpour ajuster les seuils qui déterminent quand ces variables à faible variabilité déclenchent une alerteATTENTION.Par exemple, pour abaisser le seuil d'écart-type à 1e-5 pour un modèle géographique, ajustez la valeur
geo_std_threshold:from meridian.model import model from meridian.model.eda import eda_spec custom_std_spec = eda_spec.StandardDeviationSpec(geo_std_threshold=1e-5) mmm_eda_spec = eda_spec.EDASpec(std_spec=custom_std_spec) mmm = model.Meridian(..., eda_spec=mmm_eda_spec)Pour un modèle national, ajustez plutôt le
national_std_threshold.Filtrer les variables constantes des calculs du FIV : les variables quasi constantes peuvent entraîner des erreurs de calcul lors des calculs du facteur d'inflation de la variance (FIV). Par défaut, toute variable dont l'écart-type est inférieur à 1e-4 est exclue des calculs du FIV. Vous pouvez ajuster cette limite à l'aide du paramètre
std_thresholddansVIFSpec. Par exemple, pour augmenter ce seuil à 1e-3 :from meridian.model import model from meridian.model.eda import eda_spec custom_vif_std = eda_spec.VIFSpec(std_threshold=1e-3) mmm_eda_spec = eda_spec.EDASpec(vif_spec=custom_vif_std) mmm = model.Meridian(..., eda_spec=mmm_eda_spec)