

मकसद
High Volume Address Validation ट्यूटोरियल में, आपको उन अलग-अलग स्थितियों के बारे में बताया गया है जिनमें हाई वॉल्यूम एड्रेस वैलिडेशन का इस्तेमाल किया जा सकता है. इस ट्यूटोरियल में, हम आपको Google Cloud Platform में मौजूद अलग-अलग डिज़ाइन पैटर्न के बारे में बताएंगे. इनका इस्तेमाल करके, बड़ी संख्या में पतों की पुष्टि की जा सकती है.
सबसे पहले, हम आपको Google Cloud Platform में High Volume Address Validation को Cloud Run, Compute Engine या Google Kubernetes Engine के साथ इस्तेमाल करने के बारे में बताएंगे. इससे आपको पता चलेगा कि एक बार में कई पतों की पुष्टि कैसे की जाती है. इसके बाद, हम देखेंगे कि इस सुविधा को डेटा पाइपलाइन के हिस्से के तौर पर कैसे शामिल किया जा सकता है.
इस लेख के आखिर तक, आपको अपने Google Cloud एनवायरमेंट में बड़ी संख्या में पतों की पुष्टि करने के लिए, Address Validation को चलाने के अलग-अलग विकल्पों के बारे में अच्छी जानकारी मिल जाएगी.
Google Cloud Platform पर रेफ़रंस आर्किटेक्चर
इस सेक्शन में, Google Cloud Platform का इस्तेमाल करके, High Volume Address Validation के लिए अलग-अलग डिज़ाइन पैटर्न के बारे में ज़्यादा जानकारी दी गई है. Google Cloud Platform पर काम करने से, इसे अपनी मौजूदा प्रोसेस और डेटा पाइपलाइन के साथ इंटिग्रेट किया जा सकता है.
Google Cloud Platform पर, High Volume Address Validation को एक बार चलाना
यहां Google Cloud Platform पर इंटिग्रेशन बनाने का रेफ़रंस आर्किटेक्चर दिखाया गया है. यह आर्किटेक्चर, एक बार होने वाले ऑपरेशन या टेस्टिंग के लिए ज़्यादा सही है.

इस मामले में, हमारा सुझाव है कि आप CSV फ़ाइल को Cloud Storage बकेट में अपलोड करें. इसके बाद, High Volume Address Validation स्क्रिप्ट को Cloud Run एनवायरमेंट से चलाया जा सकता है. हालांकि, इसे Compute Engine या Google Kubernetes Engine जैसे किसी अन्य रनटाइम एनवायरमेंट में भी चलाया जा सकता है. आउटपुट CSV को Cloud Storage बकेट में भी अपलोड किया जा सकता है.
Google Cloud Platform की डेटा पाइपलाइन के तौर पर चलाया जा रहा है
पिछले सेक्शन में दिखाया गया डिप्लॉयमेंट पैटर्न, High Volume Address Validation को एक बार इस्तेमाल करने के लिए तुरंत टेस्ट करने का एक बेहतरीन तरीका है. हालांकि, अगर आपको डेटा पाइपलाइन के हिस्से के तौर पर इसका इस्तेमाल नियमित तौर पर करना है, तो Google Cloud Platform की नेटिव सुविधाओं का बेहतर तरीके से फ़ायदा लिया जा सकता है. इससे इसे और बेहतर बनाया जा सकता है. इनमें से कुछ बदलाव ये हैं:
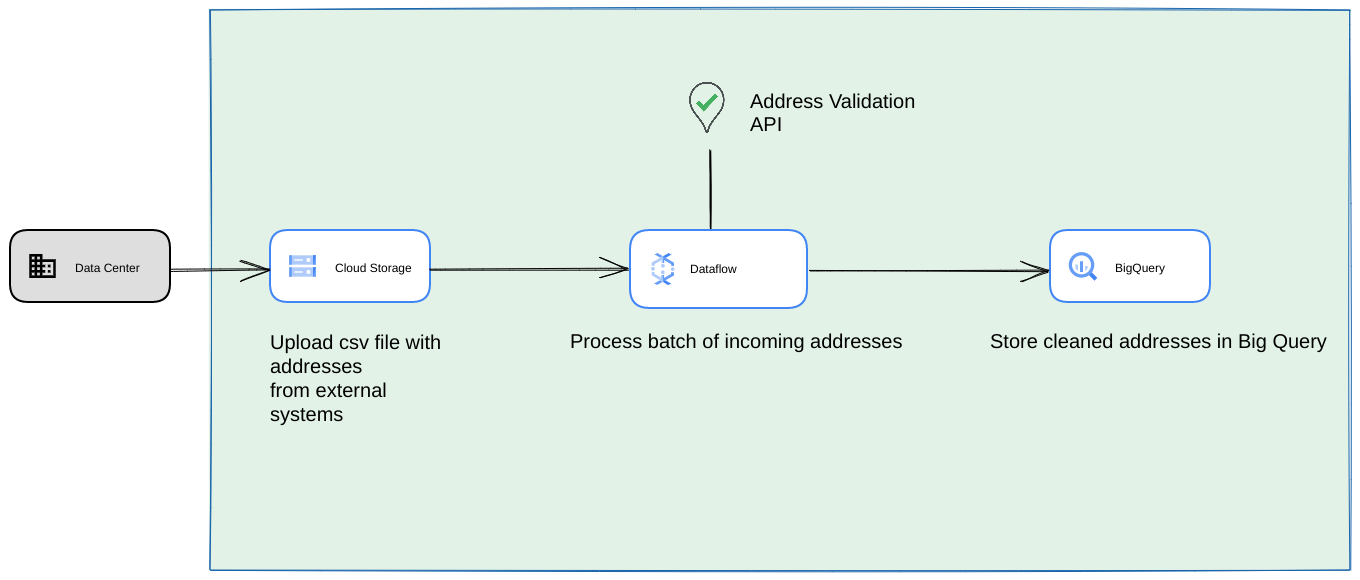
- इस मामले में, CSV फ़ाइलों को Cloud Storage बकेट में डंप किया जा सकता है.
- Dataflow जॉब, प्रोसेस किए जाने वाले पतों को चुन सकता है. इसके बाद, उन्हें BigQuery में कैश मेमोरी में सेव कर सकता है.
- Dataflow Python लाइब्रेरी को बड़ा किया जा सकता है, ताकि Dataflow जॉब से पतों की पुष्टि करने के लिए, High Volume Address Validation का लॉजिक इस्तेमाल किया जा सके.
डेटा पाइपलाइन से स्क्रिप्ट को लंबे समय तक चलने वाली बार-बार होने वाली प्रोसेस के तौर पर चलाना
एक अन्य सामान्य तरीका यह है कि पतों के बैच की पुष्टि, स्ट्रीमिंग डेटा पाइपलाइन के हिस्से के तौर पर की जाए. यह एक बार-बार होने वाली प्रोसेस है. ऐसा हो सकता है कि आपके पास BigQuery डेटास्टोर में पते हों. इस तरीके में, हम देखेंगे कि बार-बार होने वाली डेटा पाइपलाइन कैसे बनाई जाती है. इसे रोज़, हफ़्ते या महीने में ट्रिगर करना ज़रूरी है
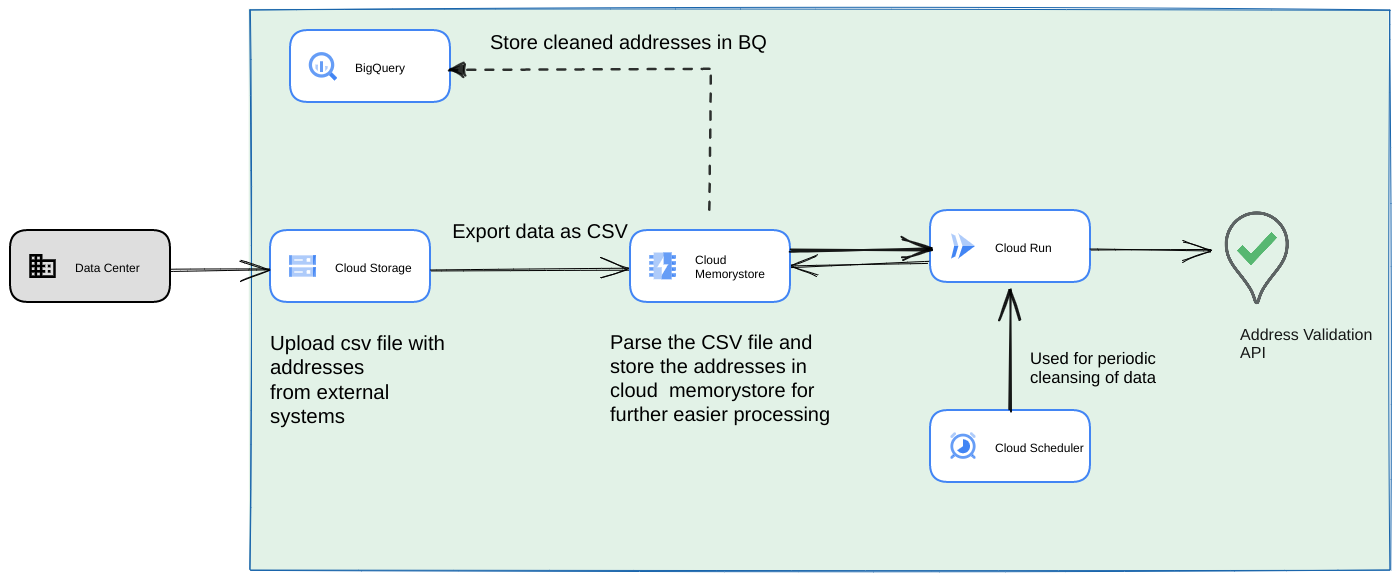
- शुरुआती CSV फ़ाइल को Cloud Storage बकेट में अपलोड करें.
- लंबे समय तक चलने वाली प्रोसेस के लिए, इंटरमीडिएट स्टेट को बनाए रखने के लिए, Memorystore का इस्तेमाल, स्थायी डेटास्टोर के तौर पर करें.
- BigQuery डेटास्टोर में, पतों को कैश मेमोरी में सेव करें.
- स्क्रिप्ट को समय-समय पर चलाने के लिए, Cloud Scheduler सेट अप करें.
इस आर्किटेक्चर के ये फ़ायदे हैं:
- Cloud Scheduler का इस्तेमाल करके, पते की पुष्टि समय-समय पर की जा सकती है. आपको हर महीने पतों की फिर से पुष्टि करनी पड़ सकती है या हर महीने/तिमाही के हिसाब से नए पतों की पुष्टि करनी पड़ सकती है. यह आर्किटेक्चर, इस इस्तेमाल के उदाहरण को हल करने में मदद करता है.
अगर ग्राहक से जुड़ा डेटा BigQuery में है, तो पुष्टि किए गए पतों या पुष्टि करने वाले फ़्लैग को सीधे वहां कैश मेमोरी में सेव किया जा सकता है. ध्यान दें: High Volume Address Validation के बारे में जानकारी देने वाले लेख में, इस बारे में ज़्यादा जानकारी दी गई है कि किस तरह के डेटा को कैश मेमोरी में सेव किया जा सकता है और कैसे.
Memorystore का इस्तेमाल करने से, ज़्यादा पतों को प्रोसेस करने की क्षमता मिलती है. साथ ही, सिस्टम को ज़्यादा बेहतर बनाया जा सकता है. इस चरण से, पूरी प्रोसेसिंग पाइपलाइन में स्टेटफ़ुलनेस जुड़ जाती है. यह पतों के बहुत बड़े डेटासेट को मैनेज करने के लिए ज़रूरी है. यहां अन्य डेटाबेस टेक्नोलॉजी का भी इस्तेमाल किया जा सकता है. जैसे, Cloud SQL[https://cloud.google.com/sql] या Google Cloud Platform पर उपलब्ध कोई अन्य डेटाबेस. हालांकि, हमारा मानना है कि Memorystore, स्केलिंग और आसानी से इस्तेमाल करने की ज़रूरतों को बेहतर तरीके से पूरा करता है. इसलिए, इसे पहली प्राथमिकता दी जानी चाहिए.
नतीजा
यहां बताए गए पैटर्न लागू करके, Google Cloud Platform पर अलग-अलग कामों के लिए Address Validation API का इस्तेमाल किया जा सकता है.
हमने एक ओपन-सोर्स Python लाइब्रेरी बनाई है, ताकि ऊपर बताए गए इस्तेमाल के उदाहरणों को शुरू करने में आपकी मदद की जा सके. इसे आपके कंप्यूटर पर कमांड लाइन से या Google Cloud Platform या क्लाउड की सेवा देने वाली अन्य कंपनियों से शुरू किया जा सकता है.
लाइब्रेरी का इस्तेमाल करने के तरीके के बारे में ज़्यादा जानने के लिए, यह लेख पढ़ें.
अगले चरण
Improve checkout, delivery, and operations with reliable addresses व्हाइटपेपर डाउनलोड करें और Improving checkout, delivery, and operations with Address Validation वेबिनार देखें.
इस बारे में और पढ़ें:
- Address Validation API से जुड़ा दस्तावेज़
- जियोकोडिंग और पते की पुष्टि
- Address Validation का डेमो देखें
योगदानकर्ता
Google इस लेख को मैनेज करता है. इसे मूल रूप से इन योगदान देने वालों ने लिखा है.
मुख्य लेखक:
हेनरिक वाल्व | सलूशन इंजीनियर
थॉमस ऐंगलरेट | सलूशन इंजीनियर
सार्थक गांगुली | सलूशन इंजीनियर