

このドキュメントでは、Google Cloud BigQuery と Google Maps Platform Datasets API の位置情報を使用して、地図データの可視化を作成するためのリファレンス アーキテクチャと例を示します。たとえば、オープンな自治体データの分析、通信カバレッジ マップの作成、移動車両の移動トレースの可視化などです。
地図データの可視化は、ユーザーを引き付け、位置情報から空間的な分析情報を引き出すための強力なツールです。位置情報データは、ポイント、ライン、ポリゴンの特徴を持つデータです。たとえば、天気図は、消費者が旅行を計画したり、嵐に備えたりするのに役立ちます。ビジネス インテリジェンス マップは、ユーザーがデータ分析から分析情報を得るのに役立ちます。通信マップは、ユーザーが特定のサービスエリアにおけるプロバイダのサービス提供範囲と品質を把握するのに役立ちます。
しかし、アプリ デベロッパーにとって、パフォーマンスが高く、優れたユーザー エクスペリエンスを提供する大規模な地図データの可視化を行うことは困難です。大量のデータをクライアントサイドのメモリに読み込む必要があるため、最初の地図の読み込み時間が長くなります。ビジュアルは、メモリや GPU の制約があるローエンドのスマートフォンを含むすべてのデバイスで、高いパフォーマンスを発揮する必要があります。最後に、デベロッパーは、ポータブルで信頼性が高く、大規模なデータでパフォーマンスを発揮する大規模なデータ レンダリング ライブラリを選択する必要があります。
リファレンス アーキテクチャ
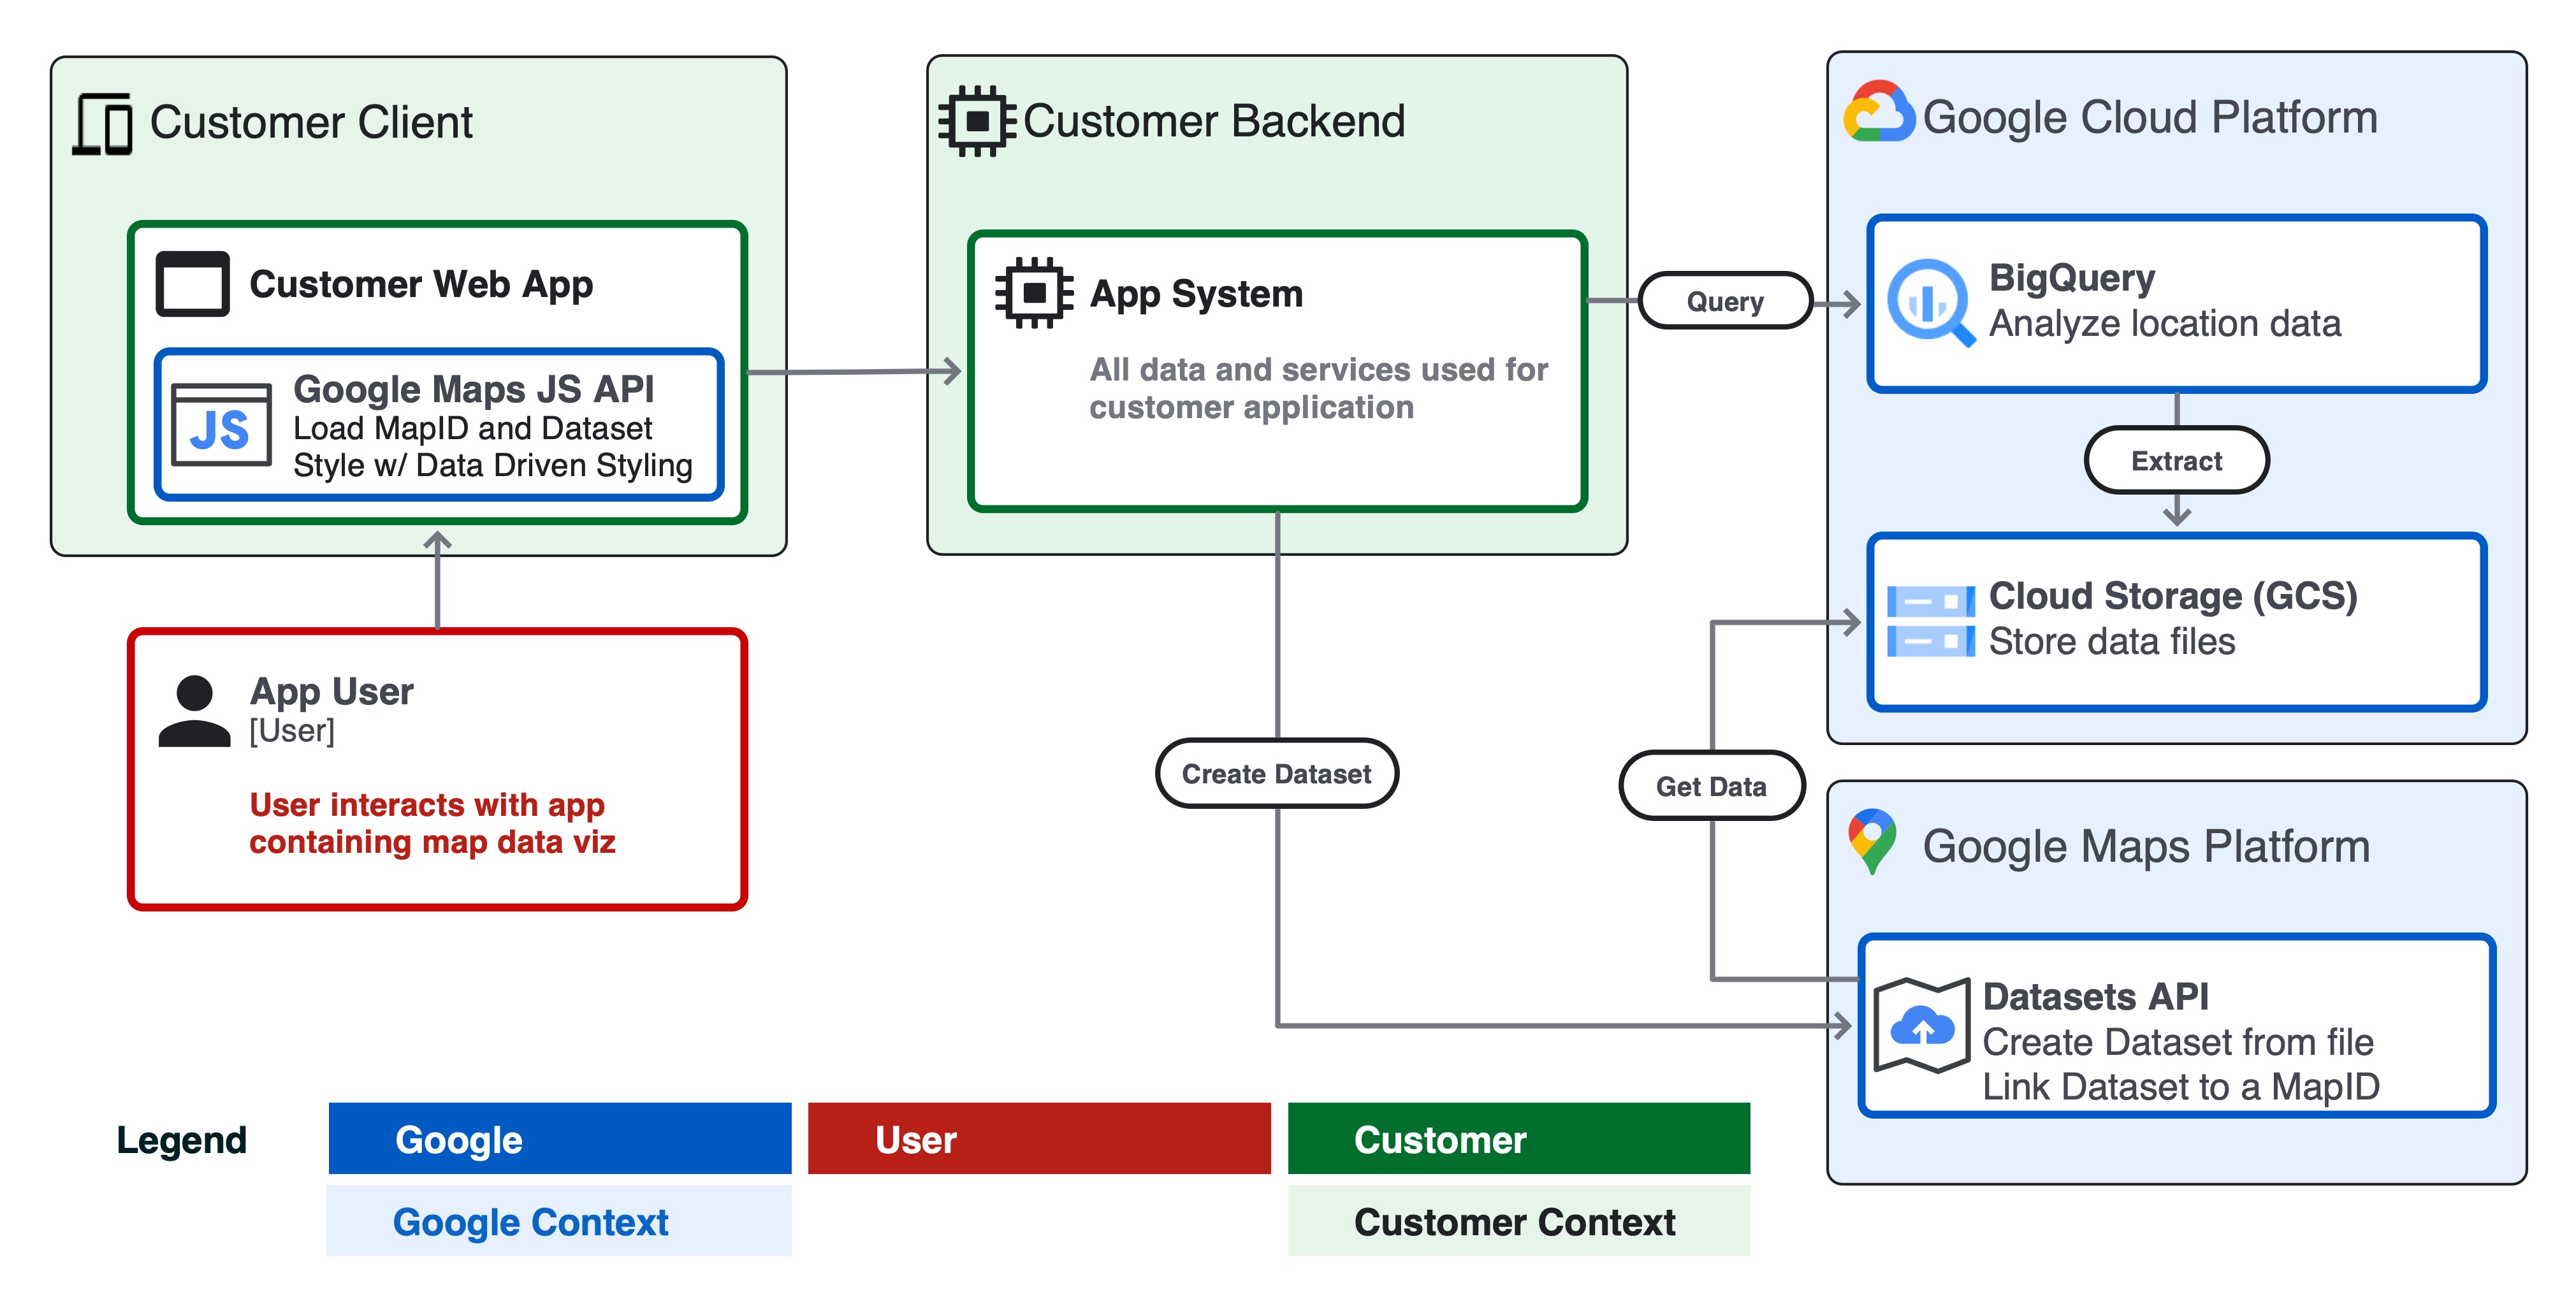
大規模なデータ ビジュアリゼーションを使用するアプリを開発するには、主に 2 つのコンポーネントが必要です。
- お客様のバックエンド - 処理やストレージなど、すべてのバックエンド アプリデータとサービス。
- 顧客クライアント - 地図のビジュアリゼーション コンポーネントを備えたアプリのユーザー インターフェース。
次のシステム図は、これら 2 つのコンポーネントがアプリユーザー、Google Cloud、Google Maps Platform とどのように連携して、大規模なデータ可視化アプリを作成するかを示しています。
設計上の考慮事項
Google Cloud と Google Maps Platform を使用してパフォーマンスの高いデータ可視化を作成するには、設計上の考慮事項がいくつかあります。
- ソースデータのサイズと更新の頻度。
- geojson 形式のソースデータが 5 MB 未満の場合や、更新頻度が非常に高い場合(リアルタイムの気象レーダー予測など)は、アプリのクライアント側で geojson オブジェクトとしてデータを提供し、deck.gl レイヤでレンダリングすることを検討してください。
- データのサイズが 5 MB を超え、更新頻度が 1 時間に 1 回以下の場合は、このドキュメントの Datasets API アーキテクチャを検討してください。
- データセットは、最大 350 MB のサイズのファイルをサポートしています。
- データが 350 MB を超える場合は、Datasets に渡す前に、ソースファイルのジオメトリ データを削除または簡素化することを検討してください(下記の「データの削除」を参照)。
- スキーマと形式
- データに、各対象物に対してグローバルに一意の ID プロパティがあることを確認します。一意の ID を使用すると、特定の対象物を選択してスタイルを設定したり、対象物にデータを結合して可視化したりできます。たとえば、ユーザーが「クリック」した対象物にスタイルを設定できます。
- Datasets API の仕様に沿って、有効な列名、データ型、GeoJSON オブジェクトのタイプを指定し、データを CSV または GeoJSON 形式でフォーマットします。
- BigQuery からデータセットを簡単に作成するには、SQL CSV エクスポートに
wktという名前の列を作成します。データセットでは、wktという名前の列から Well-Known Text(WKT)形式で CSV からジオメトリをインポートできます。 - データが有効なジオメトリとデータ型であることを確認します。たとえば、GeoJSON は WGS84 座標系、ジオメトリの巻き順などである必要があります。
- geojson-validate などのツールを使用して、ソースファイル内のすべてのジオメトリが有効であることを確認するか、ogr2ogr を使用して、ソースファイルの形式または座標系を変換します。
- データのプルーニング
- 対象物のプロパティの数を最小限に抑えます。実行時に固有識別子キーを使用して、地図対象物に追加のプロパティを結合できます(例)。
- 可能な場合は、プロパティ オブジェクトに整数データ型を使用して、タイルのストレージ容量を最小限に抑え、クライアント アプリで HTTPS 経由で読み込む際のタイルのパフォーマンスを維持します。
- 非常に複雑な対象物のジオメトリを簡略化または集約します。複雑なポリゴン ジオメトリに対して ST_Simplify などの BigQuery 関数を使用して、ソースファイルのサイズを縮小し、地図のパフォーマンスを向上させることを検討してください。
- タイリング
- Google Maps Datasets API は、ウェブまたはモバイルの Maps SDK で使用する地図タイルをソースデータ ファイルから作成します。
- 地図タイルは、ズームベースのインデックス システムで、ビジュアル アプリにデータをより効率的に読み込むことができます。
- 地図タイルは、低いズームレベルでは、密度の高い対象物や複雑な対象物が削除されることがあります。ユーザーが州または国にズームアウト(たとえば、z5 ~ z12)すると、都市または地区にズームインした(たとえば、z13 ~ z18)ときとは異なって表示される場合があります。
例 - ロンドンの鉄道
この例では、リファレンス アーキテクチャを適用して、Open Street Map(OSM)データからロンドンのすべての鉄道を可視化するウェブ アプリケーションを Google Cloud と Google マップで作成します。
前提条件
- BigQuery サンドボックスと Cloud コンソール へアクセスします
- Google Cloud プロジェクトと請求先アカウントが設定されていることを確認します。
ステップ 1 - BigQuery でデータをクエリする
BigQuery の一般公開データセットに移動します。データセット「bigquery-public-data」とテーブル geo_openstreetmap.planet_features には、考えられるすべての特徴を含む、全世界の Open Street Map(OSM)データが含まれています。amenity、road、landuse など、クエリに使用できるすべての機能については、OSM Wiki をご覧ください。
Cloud Shell または BigQuery Cloud コンソールを使用して、SQL でテーブルをクエリします。以下のコード スニペットでは、bq query コマンドを使用して、境界ボックスと ST_Intersects() 関数を使用し、ロンドンのみにフィルタされたすべての鉄道をクエリします。
Cloud Shell からこのクエリを実行するには、次のコードスニペットを実行して、環境のプロジェクト ID、データセット、テーブル名を更新します。
bq query --use_legacy_sql=false \
--destination_table PROJECTID:DATASET.TABLENAME \
--replace \
'SELECT
osm_id,
feature_type,
(SELECT value
         FROM   unnest(all_tags)
         WHERE  KEY = "name") AS name,
(SELECT value
         FROM   unnest(all_tags)
         WHERE  KEY = "railway") AS railway,
geometry as wkt
FROM   bigquery-public-data.geo_openstreetmap.planet_features
WHERE ("railway") IN (SELECT key FROM unnest(all_tags))
    AND ST_Intersects(
    geometry,
ST_MakePolygon(ST_MakeLine(
      [ST_GeogPoint(-0.549370, 51.725346),
      ST_GeogPoint(-0.549370, 51.2529407),
      ST_GeogPoint(0.3110581, 51.25294),
      ST_GeogPoint(0.3110581, 51.725346),
      ST_GeogPoint(-0.549370, 51.725346)]
    ))
   )'
クエリは次の結果を返します。
- 各特徴の固有識別子
osm_id feature_type(点、線など)- 特徴の
name(例:Paddington Station) railwayのタイプ(例: main、tourism、military など)- 対象物の
wkt- WKT 形式のポイント、ライン、ポリゴン ジオメトリ。WKT は、BigQuery の Geography 列がクエリで返す標準のデータ形式です。
注 - データセットを作成する前にクエリ結果を視覚的に検証するには、Looker Studio を使用して BigQuery のダッシュボードでデータをすばやく可視化できます。
テーブルを Google Cloud Storage バケットの CSV ファイルにエクスポートするには、Cloud Shell で bq extract コマンドを使用します。
bq extract \
--destination_format "CSV" \
--field_delimiter "," \
--print_header=true \
PROJECTID:DATASET.TABLENAME \
gs://BUCKET/FILENAME.csv
注: Cloud Scheduler を使用して各ステップを自動化し、データを定期的に更新できます。
ステップ 2 - CSV ファイルからデータセットを作成する
次に、Google Cloud Storage(GCS)のクエリ出力から Google Maps Platform データセットを作成します。Datasets API を使用すると、データセットを作成し、GCS でホストされているファイルからデータセットにデータをアップロードできます。
まず、Google Cloud プロジェクトで Maps Datasets API を有効にし、API ドキュメントを確認してください。アプリ バックエンドのロジックから Datasets API を呼び出すための Python クライアント ライブラリと Node.js クライアント ライブラリがあります。また、Cloud コンソールでデータセットを手動で作成するためのデータセット GUI もあります。
データセットのアップロードが完了したら、データセット GUI でデータセットをプレビューできます。

ステップ 4 - データセットをマップ ID に関連付ける
データセットを作成したら、関連付けられた地図のスタイルを使用してマップ ID を作成できます。地図のスタイル エディタで、mapId とスタイルをデータセットに関連付けることができます。また、Cloud ベースのマップのスタイル設定を適用して、マップのデザインをカスタマイズすることもできます。
ステップ 5 - クライアント アプリのマップ ビジュアリゼーションを作成する
最後に、Maps JS API を使用して、クライアントサイドのデータ可視化アプリにデータセットを追加できます。前の手順でデータセットに関連付けた mapID を使用して、地図オブジェクトを初期化します。次に、データセット レイヤのスタイルとインタラクティブ性を設定します。詳しくは、データセット用データドリブン スタイル設定の完全なガイドをご覧ください。
Maps JS API を使用すると、スタイルをカスタマイズしたり、スタイルを動的に変更するためのイベント ハンドラを追加したりできます。ドキュメントの例をご覧ください。以下では、属性「feature_type」に基づいて、この例のポイント フィーチャーとライン フィーチャーのスタイルを作成する setStyle 関数を定義します。
function setStyle(params) {
  const map.getDatasetFeatureLayer("your-dataset-id");
  const datasetFeature = params.feature;
  const type = datasetFeature.datasetAttributes["feature_type"];
if (type == "lines") {
           return {
             fillColor: "blue",
             strokeColor: "blue",
             fillOpacity: 0.5,
             strokeWeight: 1,
           }
         } else if (type == "points") {
           return {
             fillColor: "black",
             strokeColor: "black",
             strokeOpacity: 0.5,
             pointRadius: 2,
             fillOpacity: 0.5,
             strokeWeight: 1,
           }
     }
}
上記のコードを単一ページ型ウェブアプリで初期化すると、次の地図データ ビジュアルが生成されます。
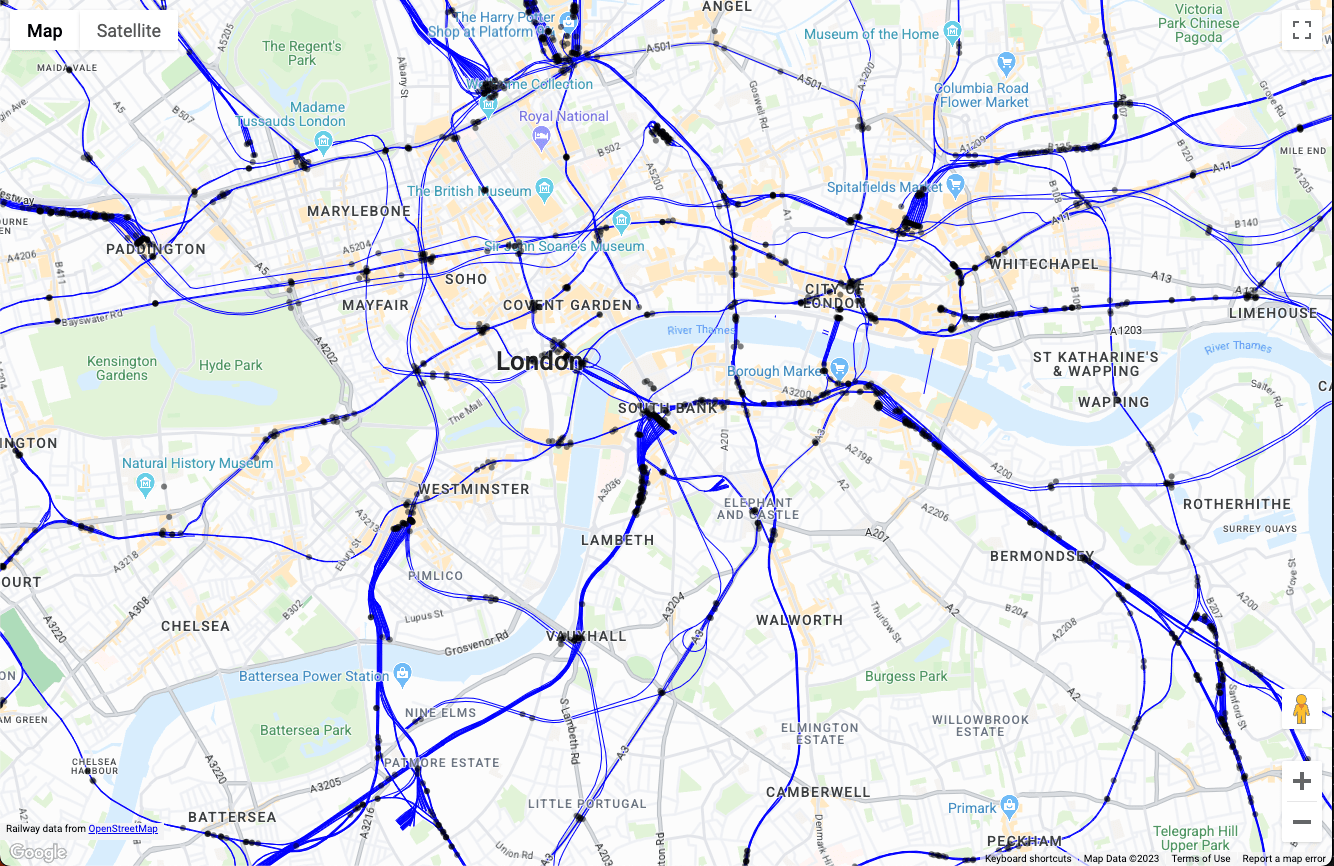
ここから、setStyle() 関数にロジックを追加して、対象物をフィルタしたり、ユーザー操作に基づいてスタイルを追加したり、アプリケーションの他の部分とやり取りしたりすることで、地図の可視化を拡張できます。
まとめ
このドキュメントでは、Google Cloud と Google Maps Platform を使用した大規模なデータ可視化アプリケーションのリファレンス アーキテクチャと実装例について説明しました。このリファレンス アーキテクチャを使用すると、Google Maps Datasets API を使用して、あらゆるデバイスでパフォーマンスを発揮する Google Cloud BigQuery の任意のデータから位置情報可視化アプリを作成できます。
次のアクション
その他の情報:
- Google Maps Platform Datasets API のドキュメント
- データドリブン スタイル設定を使ってデータをリアルタイムに確認する
- BigQuery の地理空間分析の概要
- BigQuery で GeoJSON を活用した地理空間分析
寄稿者
主な著者:
- Google Maps Platform ソリューション エンジニアリング マネージャー Ryan Baumann