

इस दस्तावेज़ में, रेफ़रंस के लिए डायग्राम और उदाहरण दिया गया है. इसकी मदद से, Google Cloud BigQuery और Google Maps Platform Datasets API में मौजूद जगह की जानकारी के डेटा से, मैप डेटा विज़ुअलाइज़ेशन बनाया जा सकता है. जैसे, नगर निगम के सार्वजनिक डेटा का विश्लेषण करना, टेलीकम्यूनिकेशन कवरेज मैप बनाना या मोबाइल वाहन फ़्लीट की गतिविधि के निशान को विज़ुअलाइज़ करना.
मैप डेटा विज़ुअलाइज़ेशन, उपयोगकर्ताओं को जोड़े रखने और जगह की जानकारी के डेटा में, जगह से जुड़ी अहम जानकारी का पता लगाने के लिए एक बेहतरीन टूल है. जगह की जानकारी के डेटा में, पॉइंट, लाइन या पॉलीगॉन फ़ीचर होते हैं. उदाहरण के लिए, मौसम के मैप से उपभोक्ताओं को यात्राएं समझने और प्लान करने में मदद मिलती है. साथ ही, वे तूफ़ानों के लिए तैयारी कर पाते हैं. बिज़नेस इंटेलिजेंस मैप से, उपयोगकर्ताओं को अपने डेटा के विश्लेषण से अहम जानकारी मिलती है. वहीं, टेलीकम्यूनिकेशन मैप से, उपयोगकर्ताओं को किसी सेवा देने वाले इलाके में, अपने सेवा देने वाले लोगों के कवरेज और क्वालिटी के बारे में जानकारी मिलती है.
हालांकि, ऐप्लिकेशन डेवलपर के लिए, बड़े मैप डेटा विज़ुअलाइज़ेशन बनाना मुश्किल होता है. ऐसा इसलिए, क्योंकि ये विज़ुअलाइज़ेशन, अच्छी परफ़ॉर्मेंस नहीं देते और उपयोगकर्ताओं को बेहतर अनुभव नहीं देते. बड़े डेटा को क्लाइंट साइड की मेमोरी में लोड करना पड़ता है. इस वजह से, मैप को पहली बार लोड होने में ज़्यादा समय लगता है. विज़ुअल को सभी डिवाइसों पर अच्छी परफ़ॉर्मेंस देनी चाहिए. इनमें कम कीमत वाले मोबाइल फ़ोन भी शामिल हैं, जिनमें मेमोरी और जीपीयू की सीमाएं होती हैं. आखिर में, डेवलपर को डेटा रेंडर करने के लिए, ऐसी बड़ी लाइब्रेरी चुननी होती है जो पोर्टेबल, भरोसेमंद, और बड़े डेटा के साथ अच्छी परफ़ॉर्मेंस देने वाली हो.
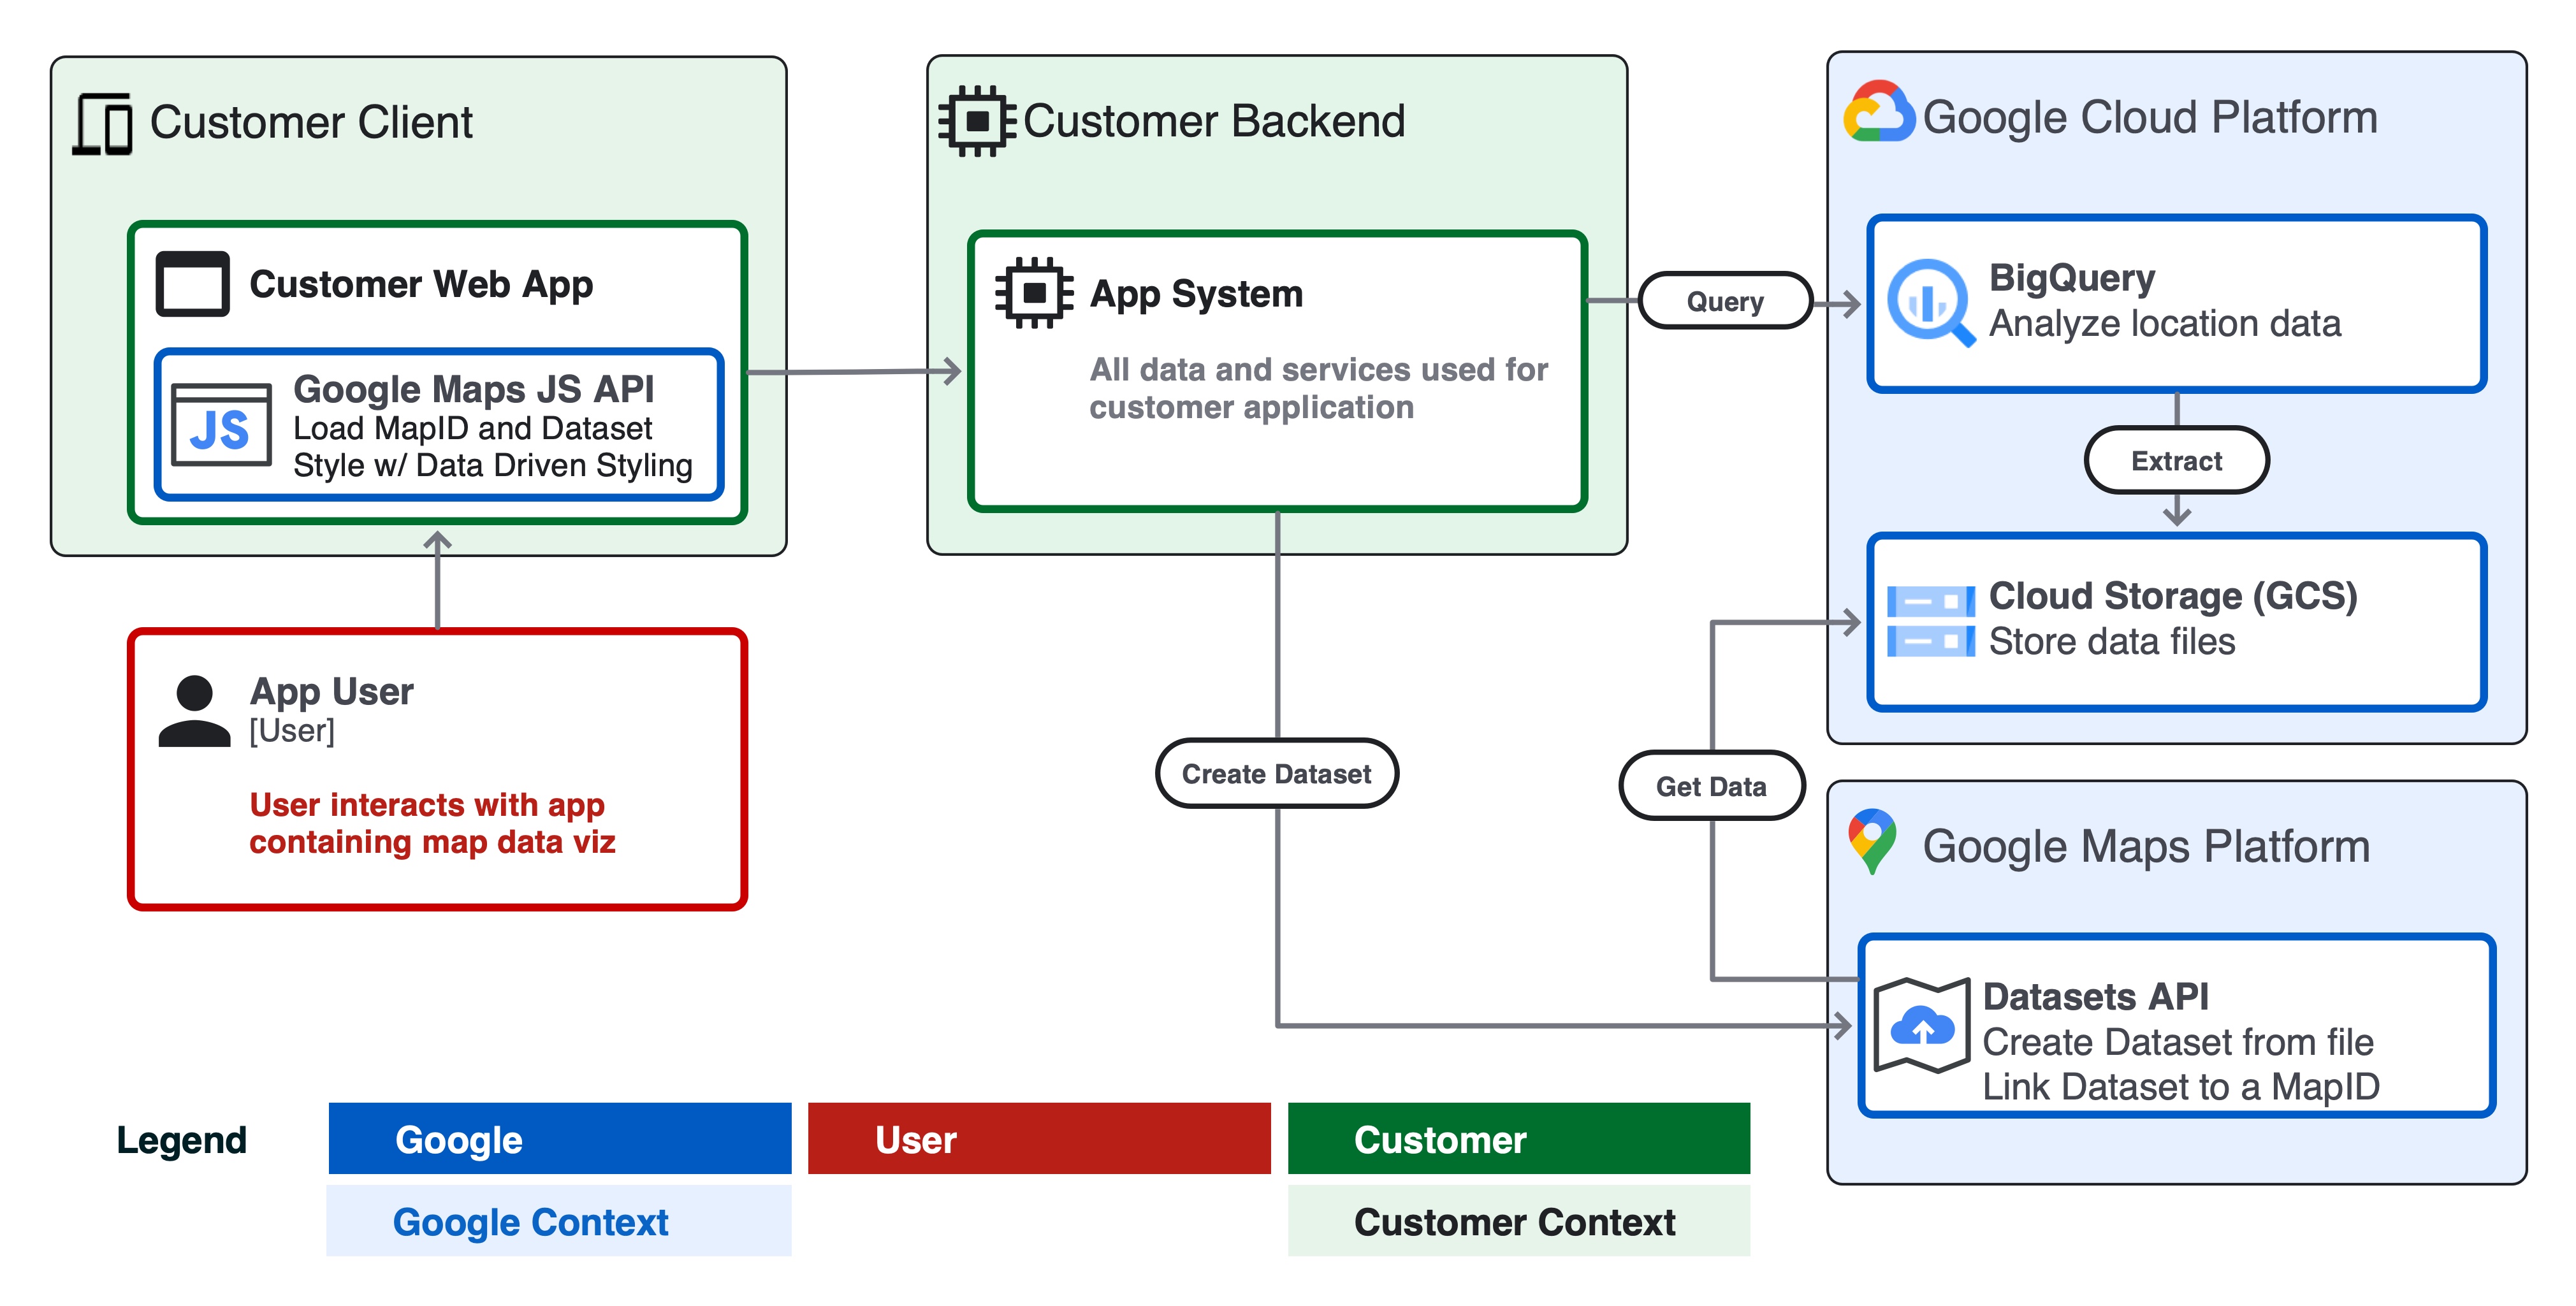
रेफ़रंस के लिए डायग्राम
बड़े डेटा विज़ुअलाइज़ेशन वाले ऐप्लिकेशन डेवलप करने के लिए, दो मुख्य कॉम्पोनेंट की ज़रूरत होती है.
- ग्राहक का बैकएंड - ऐप्लिकेशन का सभी बैकएंड डेटा और सेवाएं, जैसे कि प्रोसेसिंग और स्टोरेज.
- ग्राहक का क्लाइंट - मैप विज़ुअलाइज़ेशन कॉम्पोनेंट वाला आपके ऐप्लिकेशन का यूज़र इंटरफ़ेस.
यहां एक सिस्टम डायग्राम दिया गया है. इसमें बताया गया है कि बड़ा डेटा विज़ुअलाइज़ेशन वाला ऐप्लिकेशन बनाने के लिए, ये दोनों कॉम्पोनेंट, ऐप्लिकेशन के उपयोगकर्ता, Google Cloud, और Google Maps Platform के साथ कैसे इंटरैक्ट करते हैं.
डिज़ाइन से जुड़ी ज़रूरी बातें
Google Cloud और Google Maps Platform का इस्तेमाल करके, अच्छी परफ़ॉर्मेंस देने वाला डेटा विज़ुअलाइज़ेशन बनाने के लिए, डिज़ाइन से जुड़ी कुछ ज़रूरी बातों का ध्यान रखना होता है.
- सोर्स डेटा का साइज़ और अपडेट का अंतराल.
- अगर geojson फ़ॉर्मैट में सोर्स डेटा का साइज़ पांच एमबी से कम है या यह बहुत बार अपडेट होता है. जैसे, मौसम के रडार का लाइव पूर्वानुमान, तो अपने ऐप्लिकेशन में क्लाइंट साइड पर geojson ऑब्जेक्ट के तौर पर डेटा दिखाने और deck.gl लेयर के साथ रेंडर करने पर विचार करें.
- अगर आपके डेटा का साइज़ पांच एमबी से ज़्यादा है और यह हर घंटे में एक बार से ज़्यादा अपडेट नहीं होता है, तो इस दस्तावेज़ में दिए गए Datasets API के आर्किटेक्चर पर विचार करें.
- डेटासेट में 350 एमबी तक की फ़ाइलें सेव की जा सकती हैं.
- अगर आपका डेटा 350 एमबी से ज़्यादा है, तो डेटासेट में पास करने से पहले, सोर्स फ़ाइल में मौजूद ज्यामिति डेटा को कम करने या आसान बनाने पर विचार करें. इसके लिए, नीचे डेटा को कम करना सेक्शन देखें.
- स्कीमा और फ़ॉर्मैट
- पक्का करें कि आपके डेटा में हर फ़ीचर के लिए, दुनिया भर में यूनीक आईडी प्रॉपर्टी हो. यूनीक आईडी की मदद से, किसी खास फ़ीचर को चुना और स्टाइल किया जा सकता है. साथ ही, डेटा को किसी फ़ीचर से जोड़कर उसे विज़ुअलाइज़ किया जा सकता है. उदाहरण के लिए, “क्लिक” उपयोगकर्ता इवेंट पर चुने गए फ़ीचर को स्टाइल करना.
- Datasets API की खास जानकारी के मुताबिक, अपने डेटा को CSV या GeoJSON के तौर पर फ़ॉर्मैट करें. इसमें कॉलम के मान्य नाम, डेटा टाइप, और GeoJSON ऑब्जेक्ट के टाइप शामिल होने चाहिए.
- BigQuery से डेटासेट आसानी से बनाने के लिए, अपने एसक्यूएल CSV एक्सपोर्ट में
wktनाम का एक कॉलम बनाएं. डेटासेट में,wktनाम के कॉलम से, वेल-नोन टेक्स्ट (डब्ल्यूकेटी) फ़ॉर्मैट में CSV से ज्यामिति इंपोर्ट की जा सकती है. - पक्का करें कि आपका डेटा, मान्य ज्यॉमेट्री और डेटा टाइप में हो. उदाहरण के लिए, GeoJSON, WGS84 कॉर्डिनेट सिस्टम, ज्यॉमेट्री वाइंडिंग ऑर्डर वगैरह में होना चाहिए.
- पक्का करें कि सोर्स फ़ाइल में मौजूद सभी ज्यॉमेट्री मान्य हों. इसके लिए, geojson-validate जैसे टूल का इस्तेमाल करें. इसके अलावा, ogr2ogr का इस्तेमाल करके, सोर्स फ़ाइल को अलग-अलग फ़ॉर्मैट या कॉर्डिनेट सिस्टम में बदला जा सकता है.
- डेटा को कम करना
- फ़ीचर की प्रॉपर्टी की संख्या कम करें. रनटाइम में, किसी फ़ीचर में अन्य प्रॉपर्टी जोड़ी जा सकती हैं. इसके लिए, यूनीक आइडेंटिफ़ायर कुंजी (उदाहरण) का इस्तेमाल किया जा सकता है.
- प्रॉपर्टी ऑब्जेक्ट के लिए, जहां तक हो सके इंटिजर डेटा टाइप का इस्तेमाल करें. इससे टाइल स्टोरेज स्पेस कम हो जाता है. साथ ही, क्लाइंट ऐप्लिकेशन में एचटीटीपीएस पर टाइल लोड करने की परफ़ॉर्मेंस बेहतर बनी रहती है.
- बहुत जटिल फ़ीचर ज्यॉमेट्री को आसान बनाएं और/या इकट्ठा करें. सोर्स फ़ाइल का साइज़ कम करने और मैप की परफ़ॉर्मेंस बेहतर बनाने के लिए, जटिल पॉलीगॉन ज्यॉमेट्री पर ST_Simplify जैसे BigQuery फ़ंक्शन का इस्तेमाल करें.
- टाइलों में बांटना
- Google Maps Datasets API, आपके सोर्स डेटा फ़ाइल से मैप टाइलें बनाता है. इनका इस्तेमाल, वेब या मोबाइल Maps SDK के साथ किया जा सकता है.
- मैप टाइलें, ज़ूम पर आधारित इंडेक्सिंग सिस्टम है. इससे विज़ुअल ऐप्लिकेशन में डेटा लोड करने के ज़्यादा बेहतर तरीके मिलते हैं.
- मैप टाइलें, कम ज़ूम लेवल पर घने या जटिल फ़ीचर छोड़ सकती हैं. जब कोई उपयोगकर्ता किसी राज्य या देश (जैसे, z5-z12) पर ज़ूम आउट करता है, तो वह किसी शहर या आस-पास के इलाके (जैसे, z13-z18) पर ज़ूम इन करने पर अलग दिख सकता है.
उदाहरण - लंदन में रेलवे
इस उदाहरण में, हम रेफ़रंस के लिए डायग्राम का इस्तेमाल करके, Google Cloud और Google Maps की मदद से एक वेब ऐप्लिकेशन बनाएंगे. यह ऐप्लिकेशन, Open Street Map (OSM) डेटा से लंदन में मौजूद सभी रेलवे को विज़ुअलाइज़ करेगा.
ज़रूरी शर्तें
- BigQuery सैंडबॉक्स और Cloud Console का ऐक्सेस
- पक्का करें कि आपके पास Google Cloud प्रोजेक्ट और बिलिंग खाता सेटअप हो.
पहला चरण - BigQuery में डेटा की क्वेरी करना
BigQuery Public
डेटासेट पर जाएं. 'bigquery-public-data' डेटासेट और टेबल geo_openstreetmap.planet_features में, Open Street Map (OSM) का पूरी दुनिया का डेटा शामिल है. इसमें सभी संभावित फ़ीचर शामिल हैं. OSM Wiki में क्वेरी करने के लिए, उपलब्ध सभी
फ़ीचर देखें. इनमें OSM
Wiki शामिल हैं: amenity,
road, और landuse.
एसक्यूएल का इस्तेमाल करके टेबल की क्वेरी करने के लिए, Cloud Shell या BigQuery Cloud Console का इस्तेमाल करें. नीचे दिए गए कोड स्निप में, bq query कमांड का इस्तेमाल करके, सभी रेलवे की क्वेरी की गई है. इसमें बाउंडिंग बॉक्स और ST_Intersects() फ़ंक्शन का इस्तेमाल करके, सिर्फ़ लंदन के रेलवे को फ़िल्टर किया गया है.
Cloud Shell से इस क्वेरी को करने के लिए, नीचे दिया गया कोड स्निप चलाएं. साथ ही, अपने एनवायरमेंट के लिए प्रोजेक्ट आईडी, डेटासेट, और टेबल का नाम अपडेट करें.
bq query --use_legacy_sql=false \
--destination_table PROJECTID:DATASET.TABLENAME \
--replace \
'SELECT
osm_id,
feature_type,
(SELECT value
         FROM   unnest(all_tags)
         WHERE  KEY = "name") AS name,
(SELECT value
         FROM   unnest(all_tags)
         WHERE  KEY = "railway") AS railway,
geometry as wkt
FROM   bigquery-public-data.geo_openstreetmap.planet_features
WHERE ("railway") IN (SELECT key FROM unnest(all_tags))
    AND ST_Intersects(
    geometry,
ST_MakePolygon(ST_MakeLine(
      [ST_GeogPoint(-0.549370, 51.725346),
      ST_GeogPoint(-0.549370, 51.2529407),
      ST_GeogPoint(0.3110581, 51.25294),
      ST_GeogPoint(0.3110581, 51.725346),
      ST_GeogPoint(-0.549370, 51.725346)]
    ))
   )'
क्वेरी से ये नतीजे मिलते हैं:
- हर फ़ीचर के लिए, एक यूनीक आइडेंटिफ़ायर
osm_id feature_type. जैसे, पॉइंट, लाइन वगैरह- फ़ीचर का
name. जैसे,Paddington Station railwayटाइप. जैसे, मुख्य, पर्यटन, सेना वगैरह- फ़ीचर का
wkt- WKT फ़ॉर्मैट में पॉइंट, लाइन या पॉलीगॉन ज्यामिति. WKT, डेटा का स्टैंडर्ड फ़ॉर्मैट है. BigQuery के ज्यॉग्रफ़ी कॉलम, क्वेरी में इसी फ़ॉर्मैट में नतीजे दिखाते हैं.
ध्यान दें - डेटासेट बनाने से पहले, क्वेरी के नतीजों की पुष्टि करने के लिए, BigQuery से डैशबोर्ड में अपने डेटा को Looker Studio का इस्तेमाल करके, तुरंत विज़ुअलाइज़ किया जा सकता है.
टेबल को Google Cloud Storage बकेट में CSV फ़ाइल के तौर पर एक्सपोर्ट करने के लिए, Cloud Shell में bq extract कमांड का इस्तेमाल करें:
bq extract \
--destination_format "CSV" \
--field_delimiter "," \
--print_header=true \
PROJECTID:DATASET.TABLENAME \
gs://BUCKET/FILENAME.csv
ध्यान दें: अपने डेटा को नियमित तौर पर अपडेट करने के लिए, Cloud Scheduler का इस्तेमाल करके हर चरण को ऑटोमेट किया जा सकता है.
दूसरा चरण - अपनी CSV फ़ाइल से डेटासेट बनाना
इसके बाद, Google Cloud Storage (जीसीएस) पर क्वेरी के आउटपुट से, Google Maps Platform का डेटासेट बनाएं. Datasets API का इस्तेमाल करके, डेटासेट बनाया जा सकता है. इसके बाद, जीसीएस पर होस्ट की गई किसी फ़ाइल से, अपने डेटासेट में डेटा अपलोड किया जा सकता है.
शुरू करने के लिए, अपने Google Cloud प्रोजेक्ट पर Maps Datasets API चालू करें और एपीआई के दस्तावेज़ देखें. आपके ऐप्लिकेशन के बैकएंड में मौजूद लॉजिक से, Datasets API को कॉल करने के लिए, Python और Node.js क्लाइंट लाइब्रेरी मौजूद हैं. इसके अलावा, Cloud Console में मैन्युअल तरीके से डेटासेट बनाने के लिए, Datasets GUI भी मौजूद है.
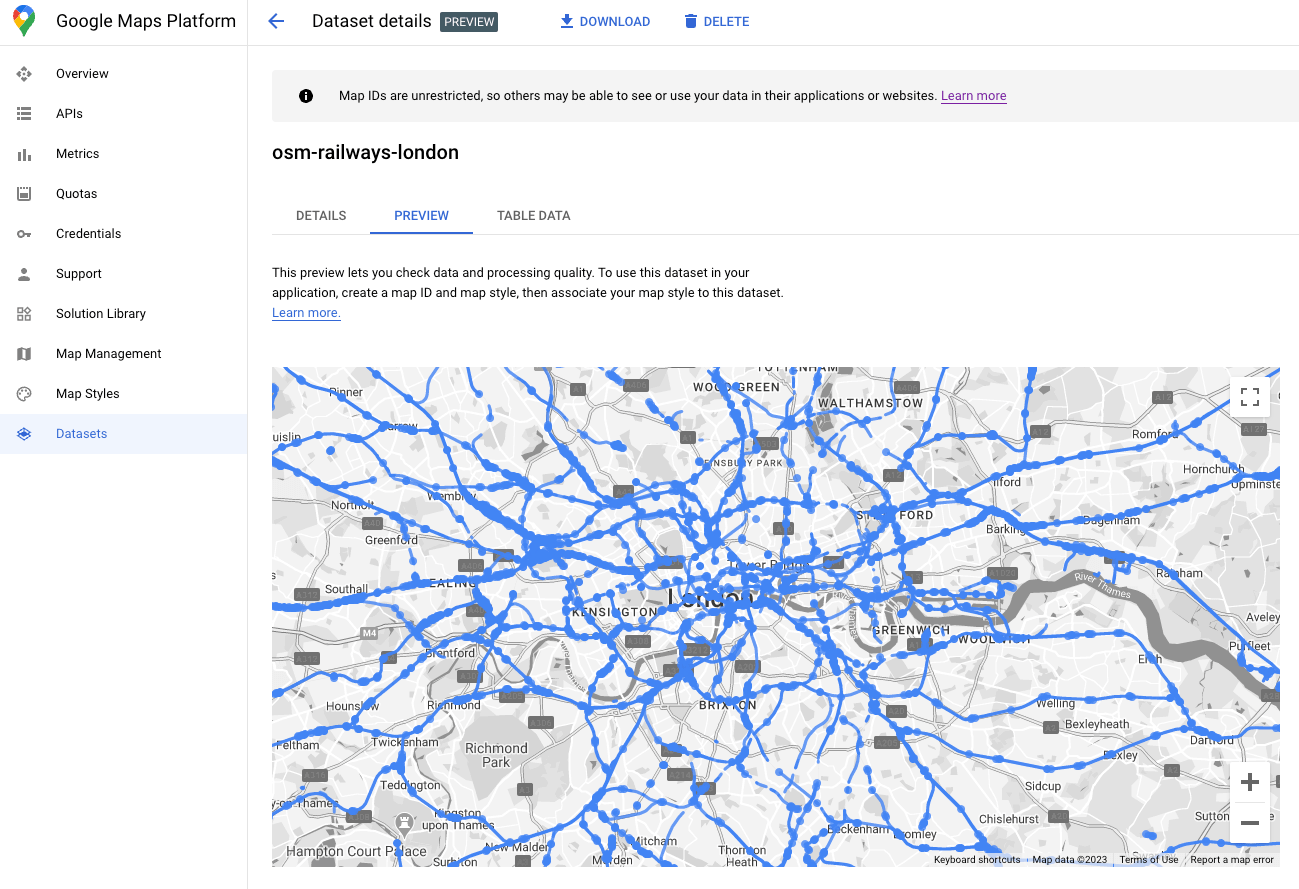
डेटासेट अपलोड होने के बाद, Datasets GUI में अपने डेटासेट का प्रीव्यू देखा जा सकता है.
चौथा चरण - अपने डेटासेट को मैप आईडी से जोड़ना
डेटासेट बनाने के बाद, आप मैप आईडी बना सकते हैं. इसके साथ, मैप की स्टाइल भी जोड़ी जा सकती है. Map Style Editor में, डेटासेट के साथ mapId और स्टाइल जोड़ी जा सकती है. यहां, Cloud Based Map Styling को लागू करके, अपने मैप के लुक और फ़ील को पसंद के मुताबिक बनाया जा सकता है.
पांचवां चरण - अपने क्लाइंट ऐप्लिकेशन का मैप विज़ुअलाइज़ेशन बनाना
आखिर में, Maps JS API का इस्तेमाल करके, डेटासेट को क्लाइंट-साइड डेटा विज़ुअलाइज़ेशन ऐप्लिकेशन में जोड़ा जा सकता है. पिछले चरण में, अपने डेटासेट से जुड़े mapID का इस्तेमाल करके, अपने मैप ऑब्जेक्ट को शुरू करें. इसके बाद, अपने डेटासेट लेयर की स्टाइल और इंटरैक्टिविटी सेट करें. ज़्यादा जानकारी के लिए, डेटासेट के साथ डेटा के आधार पर स्टाइलिंग की पूरी गाइड देखें.
Maps JS API का इस्तेमाल करके, स्टाइल को पसंद के मुताबिक बनाया जा सकता है. साथ ही, स्टाइल को डाइनैमिक तरीके से बदलने के लिए, इवेंट हैंडलर जोड़े जा सकते हैं और भी बहुत कुछ किया जा सकता है. उदाहरण के लिए, दस्तावेज़ देखें . यहां, हम "feature_type" एट्रिब्यूट के आधार पर, इस उदाहरण के लिए पॉइंट और लाइन फ़ीचर स्टाइल बनाने के लिए, setStyle फ़ंक्शन तय करेंगे.
function setStyle(params) {
  const map.getDatasetFeatureLayer("your-dataset-id");
  const datasetFeature = params.feature;
  const type = datasetFeature.datasetAttributes["feature_type"];
if (type == "lines") {
           return {
             fillColor: "blue",
             strokeColor: "blue",
             fillOpacity: 0.5,
             strokeWeight: 1,
           }
         } else if (type == "points") {
           return {
             fillColor: "black",
             strokeColor: "black",
             strokeOpacity: 0.5,
             pointRadius: 2,
             fillOpacity: 0.5,
             strokeWeight: 1,
           }
     }
}
एक पेज वाले वेब ऐप्लिकेशन में, ऊपर दिए गए कोड को शुरू करने पर, मैप डेटा का यह विज़ुअल मिलता है:
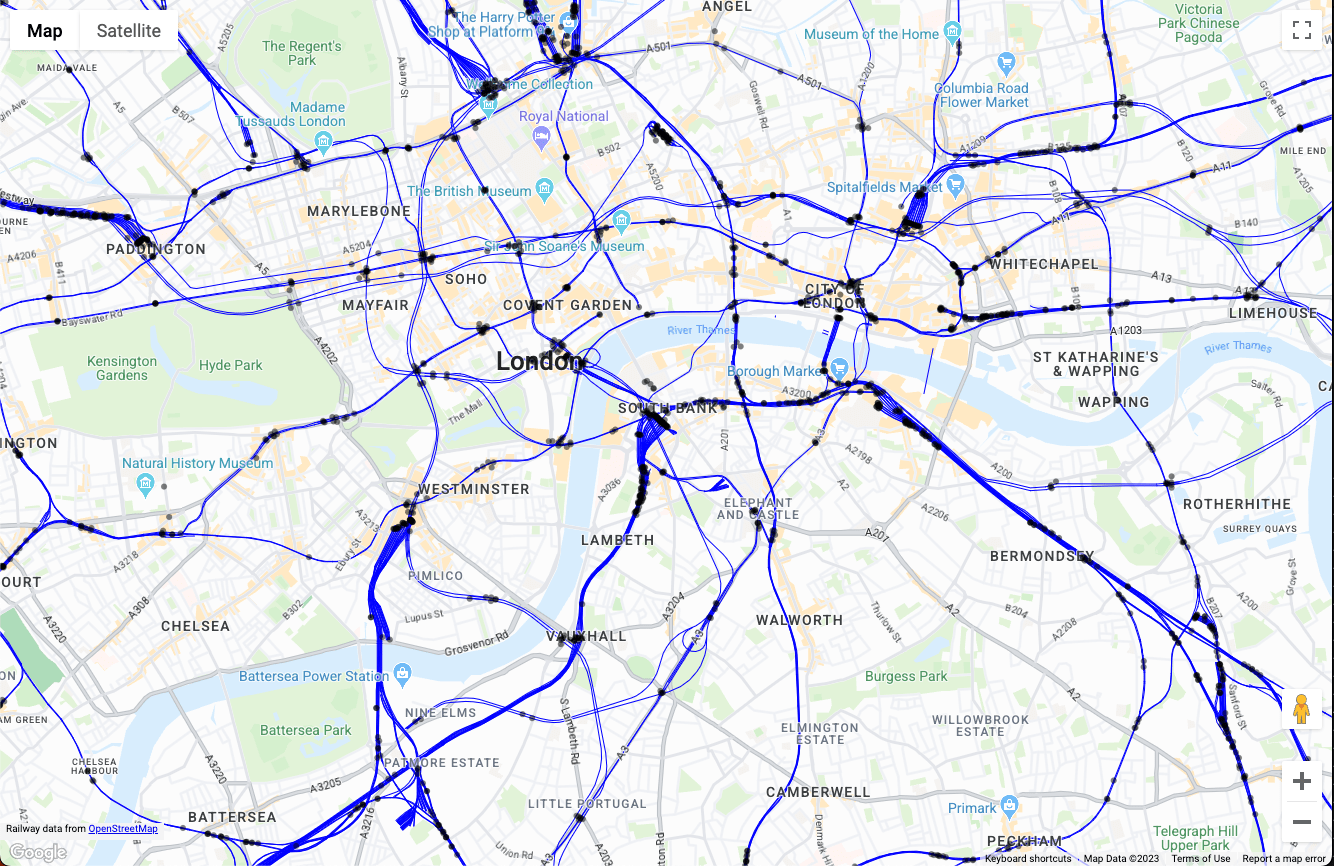
यहां से, setStyle() फ़ंक्शन में, मैप विज़ुअलाइज़ेशन को बढ़ाया जा सकता है. इसके लिए, फ़ीचर फ़िल्टर करने, उपयोगकर्ता के इंटरैक्शन के आधार पर स्टाइलिंग जोड़ने, और अपने ऐप्लिकेशन के बाकी हिस्सों के साथ इंटरैक्ट करने के लिए लॉजिक जोड़ा जा सकता है.
नतीजा
इस दस्तावेज़ में, हमने Google Cloud और Google Maps Platform का इस्तेमाल करके, बड़े डेटा विज़ुअलाइज़ेशन ऐप्लिकेशन के रेफ़रंस के लिए डायग्राम और उदाहरण के तौर पर लागू करने के बारे में चर्चा की. रेफ़रंस के लिए इस डायग्राम का इस्तेमाल करके, Google Cloud BigQuery में मौजूद किसी भी डेटा से, जगह की जानकारी के डेटा को विज़ुअलाइज़ करने वाले ऐप्लिकेशन बनाए जा सकते हैं. ये ऐप्लिकेशन, Google Maps Datasets API का इस्तेमाल करके, किसी भी डिवाइस पर अच्छी परफ़ॉर्मेंस देते हैं.
अगली कार्रवाइयां
ज़्यादा जानकारी के लिए, ये लेख पढ़ें:
- Google Maps Platform Datasets API का दस्तावेज़
- डेटा ड्राइव स्टाइल की मदद से, रीयल टाइम में अपना डेटा देखना
- BigQuery में जियोस्पेशल ऐनलिटिक्स के बारे में जानकारी
- जियोस्पेशल ऐनलिटिक्स के लिए, BigQuery में GeoJSON का इस्तेमाल करना
योगदानकर्ता
मुख्य लेखक:
- रायन बॉमन, Google Maps Platform के सलूशन इंजीनियरिंग मैनेजर