Wenn Sie direkt auf Places Insights-Daten zugreifen möchten, schreiben Sie SQL-Abfragen in BigQuery, die aggregierte Informationen zu Orten zurückgeben. Die Ergebnisse werden aus dem Dataset für die in der Abfrage angegebenen Suchkriterien zurückgegeben.
Informationen zum Aggregationsschwellenwert
Bei Standard-SQL-Abfragen, die direkt für die Rohtabellen ausgeführt werden, wird ein strenger Aggregationsschwellenwert erzwungen. Eine Ausgabezeile wird nur generiert, wenn die berechnete Aggregationsanzahl 5 oder höher ist.
Wenn die Filter Ihrer Abfrage eine Anzahl von 0, 1, 2, 3 oder 4 ergeben, wird die gesamte Ergebniszeile aus der Antwort weggelassen. Wenn Ihre Anwendungslogik genaue niedrige Werte (einschließlich 0) erfordert oder einzelne Orts-IDs abrufen muss, müssen Sie das Dataset stattdessen mit den Funktionen zum Zählen von Orten abfragen.
Grundlagen zu Abfragen
Die folgende Abbildung zeigt das grundlegende Format einer Abfrage:

Die einzelnen Teile der Abfrage werden unten ausführlicher beschrieben.
Anforderungen an Abfragen
Bei SQL-Abfragen, die direkt auf dem Dataset ausgeführt werden, muss das Dataset angegeben und WITH AGGREGATION_THRESHOLD in der SELECT-Klausel enthalten sein. Andernfalls schlägt die Abfrage fehl.
In diesem Beispiel wird places_insights___us.places angegeben, um das Dataset für die USA abzufragen.
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
Geben Sie einen Projektnamen an (optional).
Optional können Sie den Projektnamen in die Abfrage aufnehmen. Wenn Sie keinen Projektnamen angeben, wird standardmäßig das aktive Projekt verwendet.
Sie können den Projektnamen angeben, wenn Sie verknüpfte Datasets mit demselben Namen in verschiedenen Projekten haben oder wenn Sie eine Tabelle außerhalb des aktiven Projekts abfragen.
Beispiel: [project name].[dataset name].places.
Aggregationsfunktion angeben
Das folgende Beispiel zeigt die unterstützten Aggregationsfunktionen von BigQuery. Mit dieser Abfrage werden die Bewertungen aller Orte in einem Umkreis von 1.000 Metern um das Empire State Building in New York City zusammengefasst, um Bewertungsstatistiken zu erstellen:
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(id) AS place_count,
  APPROX_COUNT_DISTINCT(rating) as distinct_ratings,
  COUNTIF(rating > 4.0) as good_rating_count,
  LOGICAL_AND(rating <= 5) as all_ratings_equal_or_below_five,
  LOGICAL_OR(rating = 5) as any_rating_exactly_five,
  AVG(rating) as avg_rating,
  SUM(user_rating_count) as rating_count,
  COVAR_POP(rating, user_rating_count) as rating_covar_pop,
  COVAR_SAMP(rating, user_rating_count) as rating_covar_samp,
  STDDEV_POP(rating) as rating_stddev_pop,
  STDDEV_SAMP(rating) as rating_stddev_samp,
  VAR_POP(rating) as rating_var_pop,
  VAR_SAMP(rating) as rating_var_samp,
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
  AND business_status = "OPERATIONAL"
Ergebnisse mithilfe von geografischen Polygonen und Linien filtern
Wenn Sie keine Standorteinschränkung angeben, wird die Datenaggregation auf das gesamte Dataset angewendet. In der Regel geben Sie eine Standortbeschränkung an, um einen bestimmten Bereich zu durchsuchen.
1. Mit radialen Suchpuffern filtern (ST_DWITHIN)
In dieser Beispielabfrage wird eine Zielbeschränkung mit dem Empire State Building in New York City als Mittelpunkt und einem Radius von 1.000 Metern angegeben.
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
2. Mithilfe von Polygongrenzen filtern (ST_CONTAINS)
Sie können ein Polygon verwenden, um den Suchbereich anzugeben. Wenn Sie ein Polygon verwenden, müssen die Punkte des Polygons eine geschlossene Schleife definieren, wobei der erste Punkt im Polygon mit dem letzten Punkt übereinstimmt:
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
ST_CONTAINS(ST_GEOGFROMTEXT("""POLYGON((-73.985708 40.75773,-73.993324 40.750298,
                                      -73.9857 40.7484,-73.9785 40.7575,
                                      -73.985708 40.75773))"""), point)
3. Nach Reisezeitpuffern entlang der Route filtern (LINESTRING)
Im nächsten Beispiel definieren Sie den Suchbereich mithilfe einer Linie aus verbundenen Punkten und legen den Suchradius auf 100 Meter um die Linie fest. Die Linie ähnelt einer von der Routes API berechneten Route. Die Route kann für ein Fahrzeug, ein Fahrrad oder einen Fußgänger sein:
DECLARE route GEOGRAPHY;

SET route = ST_GEOGFROMTEXT("""LINESTRING(-73.98903537033028 40.73655649223003,
                                          -73.93580216278471 40.80955538843361)""");

SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
  ST_DWITHIN(route, point, 100)
Nach Feldern im Orts-Dataset filtern
Verfeinern Sie Ihre Suche anhand der im Dataset-Schema definierten Felder. Filtern Sie die Ergebnisse nach Dataset-Feldern wie Ort regular_opening_hours, price_level und Kunde rating.
Verweisen Sie auf alle Felder im Dataset, die durch das Dataset-Schema für das gewünschte Land definiert sind. Das Dataset-Schema für jedes Land besteht aus zwei Teilen:
- Das Kernschema, das für die Datasets aller Länder gilt.
- Ein länderspezifisches Schema, das Schemakomponenten für dieses Land definiert.
Ihre Abfrage kann beispielsweise eine WHERE-Klausel enthalten, die Filterkriterien für die Abfrage definiert.
Im folgenden Beispiel werden aggregierte Daten für Orte vom Typ tourist_attraction mit einem business_status von OPERATIONAL zurückgegeben, die eine rating von mindestens 4,0 haben und bei denen allows_dogs auf true festgelegt ist:
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
AND 'tourist_attraction' IN UNNEST(types)
AND business_status = "OPERATIONAL"
AND rating >= 4.0
AND allows_dogs = true
Die nächste Abfrage gibt Ergebnisse für Orte mit mindestens acht Ladestationen für Elektrofahrzeuge zurück:
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  ev_charge_options.connector_count > 8;
Nach primärem Ortstyp und Ortstyp filtern
Jeder Ort im Dataset kann Folgendes haben:
- Einen einzelnen primären Typ, der mit dem Ort verknüpft ist und aus den unter Orts-Typen definierten Typen stammt. Der primäre Typ könnte beispielsweise
mexican_restaurantodersteak_housesein. Verwenden Sieprimary_typein einer Abfrage, um die Ergebnisse nach dem primären Typ eines Orts zu filtern. - Mehrere Typwerte, die mit dem Ort verknüpft sind und aus den unter Ortstypen definierten Typen stammen. Ein Restaurant kann beispielsweise die folgenden Typen haben:
seafood_restaurant,restaurant,food,point_of_interest,establishment. Verwenden Sietypesin einer Abfrage, um die Ergebnisse nach der Liste der mit dem Ort verknüpften Typen zu filtern.
Die folgende Abfrage gibt Ergebnisse für alle Orte mit dem primären Typ skin_care_clinic zurück, die auch als spa fungieren:
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  'spa' IN UNNEST(types)
  AND 'skin_care_clinic' = primary_type
Nach Orts-ID filtern
Im folgenden Beispiel wird die durchschnittliche Bewertung für 5 Orte berechnet. Die Orte werden anhand ihrer place_id identifiziert.
DECLARE place_ids ARRAY<STRING>;
SET place_ids = ['ChIJPQOh8YVZwokRE2WsbZI4tOk', 'ChIJibtT3ohZwokR7tX0gp0nG8U',
                 'ChIJdfD8moVZwokRO6vxjXAtoWs', 'ChIJsdNONuFbwokRLM-yuifjb8k',
                 'ChIJp0gKoClawokR0txqrcaEkFc'];
SELECT WITH AGGREGATION_THRESHOLD
 AVG(rating) as avg_rating,
FROM
  `PROJECT_NAME.places_insights___us.places`,
  UNNEST(place_ids) place_id
WHERE
  id = place_id;
Bestimmte Orts-IDs aus den Abfrageergebnissen ausschließen
Sie können auch ein Array von Orts-IDs aus einer Abfrage ausschließen.
Sie können die gewünschten Orts-IDs mit dem Orts-ID-Finder oder programmatisch über die Places API mit einer Text Search (New)-Anfrage ermitteln.
Im folgenden Beispiel wird die Anzahl der Cafés in der Postleitzahl 2000 von Sydney, Australien, ermittelt, die nicht im Array excluded_cafes enthalten sind.
Eine solche Abfrage kann für Geschäftsinhaber nützlich sein, die ihre eigenen Unternehmen von einer Zählung ausschließen möchten.
WITH excluded_cafes AS (
  -- List the specific place IDs to exclude from the final count
  SELECT * FROM UNNEST([
    'ChIJLTcYGz-uEmsRmazk9oMnP5w', 'ChIJeWDDDNOvEmsRF8SMPUwPbhw',
    'ChIJKdaKHbmvEmsRSdxq_1O05bU'
  ]) AS place_id
)

SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `places_insights___au.places` AS places
-- Perform a LEFT JOIN to identify which places are in the exclusion list
LEFT JOIN
  excluded_cafes ON places.id = excluded_cafes.place_id
WHERE
  -- Filter for specific place type and postal code
  places.primary_type = 'cafe'
  AND '2000' IN UNNEST(places.postal_code_names)
  -- Keep only the rows where the join failed (meaning the ID was NOT in the list)
  AND excluded_cafes.place_id IS NULL;
Nach vordefinierten Datenwerten filtern
Viele Dataset-Felder haben vordefinierte Werte. Beispiel:
- Das Feld
price_levelunterstützt die folgenden vordefinierten Werte:PRICE_LEVEL_FREEPRICE_LEVEL_INEXPENSIVEPRICE_LEVEL_MODERATEPRICE_LEVEL_EXPENSIVEPRICE_LEVEL_VERY_EXPENSIVE
- Das Feld
business_statusunterstützt die folgenden vordefinierten Werte:OPERATIONALCLOSED_TEMPORARILYCLOSED_PERMANENTLYFUTURE_OPENING
In diesem Beispiel gibt die Abfrage die Anzahl aller Floristen mit einem business_status von OPERATIONAL innerhalb eines Radius von 1.000 Metern um das Empire State Building in New York City zurück:
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
AND business_status = "OPERATIONAL"
AND 'florist' IN UNNEST(types)
Nach Öffnungszeiten filtern
In diesem Beispiel wird die Anzahl aller Orte in einem geografischen Gebiet mit Happy Hours am Freitag zurückgegeben:
SELECT WITH AGGREGATION_THRESHOLD COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`,
UNNEST(regular_opening_hours_happy_hour.friday) AS friday_hours
WHERE '17:00:00' BETWEEN friday_hours.start_time AND friday_hours.end_time
AND ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000);
Nach Region filtern (Adresskomponenten)
Unser Datensatz zu Orten enthält auch eine Reihe von Adresskomponenten, die sich zum Filtern von Ergebnissen nach politischen Grenzen eignen. Jede Adresskomponente wird durch ihren Textcodenamen (10002 für die Postleitzahl in NYC) oder ihre Orts-ID (ChIJm5NfgIBZwokR6jLqucW0ipg) für die entsprechende Postleitzahl-ID identifiziert.
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  '10002' IN UNNEST(postal_code_names)
  -- 'ChIJm5NfgIBZwokR6jLqucW0ipg' IN UNNEST(postal_code_ids) -- same filter as above using postal code ID
Nach Ladekonfigurationen für Elektrofahrzeuge filtern
In diesem Beispiel wird die Anzahl der Orte mit mindestens 8 Ladestationen für Elektrofahrzeuge angegeben:
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  ev_charge_options.connector_count > 8;
In diesem Beispiel wird die Anzahl der Orte gezählt, die mindestens 10 Tesla-Ladestationen haben, die schnelles Laden unterstützen:
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`, UNNEST(ev_charge_options.connector_aggregation) as connectors
WHERE
  connectors.type ='EV_CONNECTOR_TYPE_TESLA'
  AND connectors.max_charge_rate_kw >= 50
  AND connectors.count >= 10
Nach Datum des Daten-Snapshots filtern
Das Dataset „Orte“ enthält Daten zur Anzahl der Orte für jeden Monat ab Januar 2024. Wenn Sie den Snapshot der Ortsdaten für einen bestimmten Monat abfragen möchten, filtern Sie nach dem Feld „snapshot_date“.
Die folgende Abfrage gibt beispielsweise Ergebnisse zurück, die nach dem primären Typ für jeden Ort im Suchbereich im Januar 2024 gruppiert sind:
SELECT WITH AGGREGATION_THRESHOLD
  primary_type,
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places_historical`
WHERE
  snapshot_date = '2024-01-01'
  AND ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
GROUP BY
  primary_type;
Gruppierte Ergebniszeilen zurückgeben
Die bisher gezeigten Abfragen geben eine einzelne Zeile im Ergebnis zurück, die die Aggregationsanzahl für die Abfrage enthält. Sie können auch den Operator GROUP BY verwenden, um basierend auf den Gruppierungskriterien mehrere Zeilen in der Antwort zurückzugeben.
Die folgende Abfrage gibt beispielsweise Ergebnisse zurück, die nach dem primären Typ der einzelnen Orte im Suchbereich gruppiert sind:
SELECT WITH AGGREGATION_THRESHOLD
  primary_type,
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  ST_DWITHIN(ST_GEOGPOINT(-73.99992071622756, 40.71818785986936), point, 1000)
GROUP BY primary_type
Dieses Bild zeigt eine Beispielausgabe für diese Abfrage:

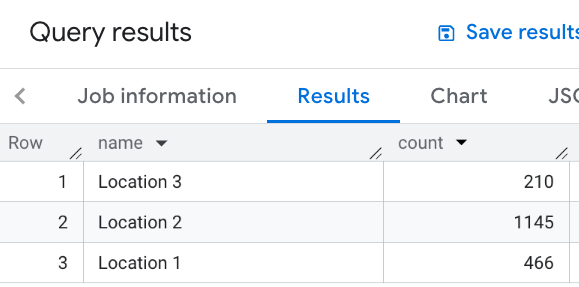
In diesem Beispiel definieren Sie eine Tabelle mit Standorten. Für jeden Standort berechnen Sie dann die Anzahl der Restaurants in der Nähe, d. h. innerhalb von 1.000 Metern:
WITH my_locations AS (
  SELECT 'Location 1' AS name, ST_GEOGPOINT(-74.00776440888504, 40.70932825380786) AS location
  UNION ALL
  SELECT 'Location 2' AS name, ST_GEOGPOINT(-73.98257192833559, 40.750738934863215) AS location
  UNION ALL
  SELECT 'Location 3' AS name, ST_GEOGPOINT(-73.94701794263223, 40.80792954838445)  AS location
)
SELECT WITH AGGREGATION_THRESHOLD
  l.name,
  COUNT(*) as count
FROM
  `PROJECT_NAME.places_insights___us.places` AS p
JOIN
   my_locations l
ON
  ST_DWITHIN(l.location, p.point, 1000)
WHERE
  primary_type = "restaurant"
  AND business_status = "OPERATIONAL"
GROUP BY
  l.name
Dieses Bild zeigt eine Beispielausgabe für diese Abfrage: