

Чтобы получить доступ к данным Places Insights, вы пишете SQL-запросы в BigQuery, которые возвращают агрегированные данные о местах. Результаты возвращаются из набора данных по критериям поиска, указанным в запросе.
Порог агрегирования
При выполнении стандартных SQL-запросов непосредственно в необработанных таблицах применяется строгий порог агрегирования. Строка вывода создается, только если рассчитанное количество агрегированных данных равно 5 или больше.
Если в результате фильтрации запроса получается 0, 1, 2, 3 или 4, вся строка результата исключается из ответа. Если логика вашего приложения требует точного подсчета небольших количеств (включая 0) или вам нужно получить отдельные идентификаторы мест, вы должны запрашивать набор данных с помощью функций подсчета мест.
Основные сведения о запросах
На изображении ниже показан базовый формат запроса.

Ниже подробно описана каждая часть запроса.
Требования к запросам
В SQL-запросах, отправляемых непосредственно в набор данных, необходимо указать набор данных и включить WITH AGGREGATION_THRESHOLD в предложение SELECT. Без этого запрос не будет выполнен.
В этом примере указано places_insights___us.places, чтобы запросить набор данных для США.
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
Укажите название проекта (необязательно).
При желании вы можете включить в запрос название проекта. Если вы не укажете название проекта, запрос по умолчанию будет выполнен в активном проекте.
Название проекта может потребоваться, если у вас есть связанные наборы данных с одинаковыми названиями в разных проектах или если вы запрашиваете таблицу за пределами активного проекта.
например [project name].[dataset name].places (2-е издание).
Укажите агрегатную функцию
В примере ниже показаны поддерживаемые агрегатные функции BigQuery. Этот запрос агрегирует оценки всех мест, расположенных в радиусе 1000 метров от Эмпайр-стейт-билдинг в Нью-Йорке, чтобы получить статистику оценок:
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(id) AS place_count,
  APPROX_COUNT_DISTINCT(rating) as distinct_ratings,
  COUNTIF(rating > 4.0) as good_rating_count,
  LOGICAL_AND(rating <= 5) as all_ratings_equal_or_below_five,
  LOGICAL_OR(rating = 5) as any_rating_exactly_five,
  AVG(rating) as avg_rating,
  SUM(user_rating_count) as rating_count,
  COVAR_POP(rating, user_rating_count) as rating_covar_pop,
  COVAR_SAMP(rating, user_rating_count) as rating_covar_samp,
  STDDEV_POP(rating) as rating_stddev_pop,
  STDDEV_SAMP(rating) as rating_stddev_samp,
  VAR_POP(rating) as rating_var_pop,
  VAR_SAMP(rating) as rating_var_samp,
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
  AND business_status = "OPERATIONAL"
Как фильтровать результаты с помощью географических многоугольников и линий
Если вы не укажете ограничение по местоположению, агрегирование данных будет применено ко всему набору данных. Обычно ограничение области поиска используется для поиска в определенной области.
1. Фильтрация с помощью буферов радиального поиска (ST_DWITHIN)
В этом примере запроса указано ограничение по целевому объекту с центром в Эмпайр-стейт-билдинг в Нью-Йорке и радиусом 1000 метров.
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
2. Фильтрация по границам многоугольника (ST_CONTAINS)
Вы можете использовать многоугольник, чтобы указать область поиска. При использовании многоугольника его точки должны определять замкнутый контур, в котором первая точка совпадает с последней:
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
ST_CONTAINS(ST_GEOGFROMTEXT("""POLYGON((-73.985708 40.75773,-73.993324 40.750298,
                                      -73.9857 40.7484,-73.9785 40.7575,
                                      -73.985708 40.75773))"""), point)
3. Фильтрация по буферным зонам вдоль маршрута (LINESTRING)
В следующем примере область поиска определяется с помощью линии соединенных точек, а радиус поиска устанавливается равным 100 метрам вокруг линии. Эта линия похожа на маршрут, рассчитанный с помощью Routes API. Маршрут может быть предназначен для автомобиля, велосипеда или пешехода:
DECLARE route GEOGRAPHY;

SET route = ST_GEOGFROMTEXT("""LINESTRING(-73.98903537033028 40.73655649223003,
                                          -73.93580216278471 40.80955538843361)""");

SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
  ST_DWITHIN(route, point, 100)
Фильтрация по полям набора данных о местах
Уточните поиск на основе полей, определенных схемой набора данных. Фильтровать результаты по полям набора данных, например по месту regular_opening_hours, price_level и клиенту rating.
Вы можете ссылаться на любые поля в наборе данных, определенные схемой набора данных для интересующей вас страны. Схема набора данных для каждой страны состоит из двух частей:
- Основная схема, которая является общей для наборов данных по всем странам.
- Схема для определенной страны, которая определяет компоненты схемы, относящиеся к этой стране.
Например, в запрос можно включить условие WHERE, которое определяет критерии фильтрации.
В следующем примере возвращаются агрегированные данные для мест типа tourist_attraction с business_status OPERATIONAL, у которых rating больше или равно 4, 0, а для allows_dogs задано значение true:
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
AND 'tourist_attraction' IN UNNEST(types)
AND business_status = "OPERATIONAL"
AND rating >= 4.0
AND allows_dogs = true
Следующий запрос возвращает результаты для мест, в которых есть не менее восьми зарядных станций для электромобилей:
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  ev_charge_options.connector_count > 8;
Фильтрация по основному типу места и типу места
У каждого места в наборе данных могут быть:
- Один основной тип, связанный с местом и выбранный из списка типов мест. Например, основным типом может быть
mexican_restaurantилиsteak_house. Используйтеprimary_typeв запросе, чтобы отфильтровать результаты по основному типу места. - Несколько значений типа, связанных с ним, из типов, определенных в разделе Типы мест. Например, для ресторана можно указать следующие типы:
seafood_restaurant,restaurant,food,point_of_interest,establishment. Используйтеtypesв запросе, чтобы отфильтровать результаты по списку типов, связанных с местом.
Следующий запрос возвращает результаты для всех мест, у которых основной тип – skin_care_clinic, а дополнительный – spa.
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  'spa' IN UNNEST(types)
  AND 'skin_care_clinic' = primary_type
Фильтр по идентификатору места
В примере ниже вычисляется средняя оценка для пяти мест. Места идентифицируются по их place_id.
DECLARE place_ids ARRAY<STRING>;
SET place_ids = ['ChIJPQOh8YVZwokRE2WsbZI4tOk', 'ChIJibtT3ohZwokR7tX0gp0nG8U',
                 'ChIJdfD8moVZwokRO6vxjXAtoWs', 'ChIJsdNONuFbwokRLM-yuifjb8k',
                 'ChIJp0gKoClawokR0txqrcaEkFc'];
SELECT WITH AGGREGATION_THRESHOLD
 AVG(rating) as avg_rating,
FROM
  `PROJECT_NAME.places_insights___us.places`,
  UNNEST(place_ids) place_id
WHERE
  id = place_id;
Как исключить определенные идентификаторы мест из результатов запроса
Вы также можете исключить из запроса массив идентификаторов мест.
Идентификаторы мест можно найти с помощью инструмента поиска идентификаторов мест или программно, отправив запрос текстового поиска (новая версия) в Places API.
В следующем примере запрос находит количество кафе в почтовом индексе 2000 Сиднея (Австралия), которые не отображаются в массиве excluded_cafes.
Такой запрос может быть полезен владельцу компании, который хочет исключить свои компании из подсчета.
WITH excluded_cafes AS (
  -- List the specific place IDs to exclude from the final count
  SELECT * FROM UNNEST([
    'ChIJLTcYGz-uEmsRmazk9oMnP5w', 'ChIJeWDDDNOvEmsRF8SMPUwPbhw',
    'ChIJKdaKHbmvEmsRSdxq_1O05bU'
  ]) AS place_id
)

SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `places_insights___au.places` AS places
-- Perform a LEFT JOIN to identify which places are in the exclusion list
LEFT JOIN
  excluded_cafes ON places.id = excluded_cafes.place_id
WHERE
  -- Filter for specific place type and postal code
  places.primary_type = 'cafe'
  AND '2000' IN UNNEST(places.postal_code_names)
  -- Keep only the rows where the join failed (meaning the ID was NOT in the list)
  AND excluded_cafes.place_id IS NULL;
Фильтрация по стандартным значениям данных
Многие поля набора данных имеют предопределенные значения. Пример:
- Поле
price_levelподдерживает следующие стандартные значения:PRICE_LEVEL_FREEPRICE_LEVEL_INEXPENSIVEPRICE_LEVEL_MODERATEPRICE_LEVEL_EXPENSIVEPRICE_LEVEL_VERY_EXPENSIVE
- Поле
business_statusподдерживает следующие стандартные значения:OPERATIONALCLOSED_TEMPORARILYCLOSED_PERMANENTLYFUTURE_OPENING
В этом примере запрос возвращает количество всех флористов с business_status, равным OPERATIONAL, в радиусе 1000 метров от Эмпайр-стейт-билдинг в Нью-Йорке:
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
AND business_status = "OPERATIONAL"
AND 'florist' IN UNNEST(types)
Фильтр по часам работы
В этом примере возвращается количество всех мест в географической области, где по пятницам проводятся счастливые часы:
SELECT WITH AGGREGATION_THRESHOLD COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`,
UNNEST(regular_opening_hours_happy_hour.friday) AS friday_hours
WHERE '17:00:00' BETWEEN friday_hours.start_time AND friday_hours.end_time
AND ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000);
Фильтр по региону (компоненты адреса)
Наш набор данных о местах также содержит набор компонентов адреса, которые полезны для фильтрации результатов на основе политических границ. Каждый компонент адреса идентифицируется текстовым кодовым названием (10002 для почтового индекса в Нью-Йорке) или идентификатором места (ChIJm5NfgIBZwokR6jLqucW0ipg) для эквивалентного идентификатора почтового индекса.
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  '10002' IN UNNEST(postal_code_names)
  -- 'ChIJm5NfgIBZwokR6jLqucW0ipg' IN UNNEST(postal_code_ids) -- same filter as above using postal code ID
Фильтрация по конфигурациям зарядки ЭМ
В этом примере показано, как получить количество мест, где есть не менее восьми зарядных устройств для электромобилей:
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  ev_charge_options.connector_count > 8;
В этом примере подсчитывается количество мест, где есть не менее 10 зарядных устройств Tesla, поддерживающих быструю зарядку:
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`, UNNEST(ev_charge_options.connector_aggregation) as connectors
WHERE
  connectors.type ='EV_CONNECTOR_TYPE_TESLA'
  AND connectors.max_charge_rate_kw >= 50
  AND connectors.count >= 10
Фильтрация по дате создания снимка данных
Набор данных о местах содержит данные о количестве мест за каждый месяц, начиная с января 2024 года. Чтобы запросить данные о местах за определенный месяц, используйте фильтр по полю snapshot_date.
Например, следующий запрос возвращает результаты, сгруппированные по основному типу для каждого места в области поиска, за январь 2024 года:
SELECT WITH AGGREGATION_THRESHOLD
  primary_type,
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places_historical`
WHERE
  snapshot_date = '2024-01-01'
  AND ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
GROUP BY
  primary_type;
Возврат сгруппированных строк результатов
Показанные выше запросы возвращают в результате одну строку, содержащую агрегированное количество для запроса. Вы также можете использовать оператор GROUP BY, чтобы возвращать в ответе несколько строк на основе критериев группировки.
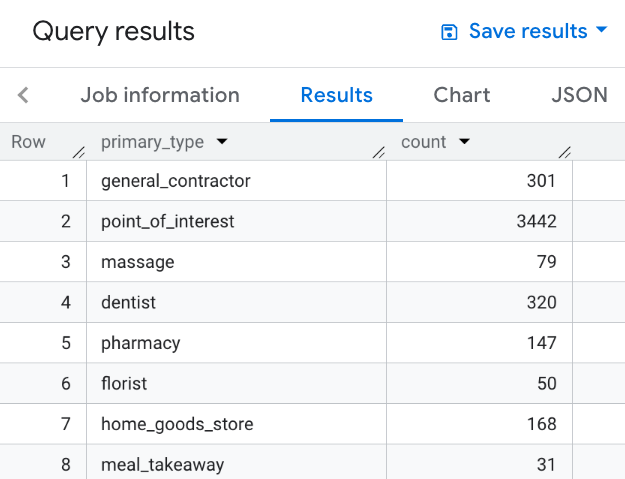
Например, следующий запрос возвращает результаты, сгруппированные по основному типу каждого места в области поиска:
SELECT WITH AGGREGATION_THRESHOLD
  primary_type,
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  ST_DWITHIN(ST_GEOGPOINT(-73.99992071622756, 40.71818785986936), point, 1000)
GROUP BY primary_type
На изображении показан пример результата по этому запросу:
В этом примере вы определяете таблицу местоположений. Для каждого местоположения вычисляется количество ресторанов поблизости, то есть в пределах 1000 метров:
WITH my_locations AS (
  SELECT 'Location 1' AS name, ST_GEOGPOINT(-74.00776440888504, 40.70932825380786) AS location
  UNION ALL
  SELECT 'Location 2' AS name, ST_GEOGPOINT(-73.98257192833559, 40.750738934863215) AS location
  UNION ALL
  SELECT 'Location 3' AS name, ST_GEOGPOINT(-73.94701794263223, 40.80792954838445)  AS location
)
SELECT WITH AGGREGATION_THRESHOLD
  l.name,
  COUNT(*) as count
FROM
  `PROJECT_NAME.places_insights___us.places` AS p
JOIN
   my_locations l
ON
  ST_DWITHIN(l.location, p.point, 1000)
WHERE
  primary_type = "restaurant"
  AND business_status = "OPERATIONAL"
GROUP BY
  l.name
На изображении показан пример результата по этому запросу:
