

如需直接访问地点数据分析数据,您可以在 BigQuery 中编写 SQL 查询,以返回有关地点的汇总数据分析。系统会从数据集中返回与查询中指定的搜索条件相符的结果。
了解汇总阈值
直接在原始表上运行的标准 SQL 查询会强制执行严格的汇总阈值。仅当计算出的汇总计数为 5 或更高时,系统才会生成输出行。
如果您的查询过滤条件产生的结果数量为 0、1、2、3 或 4,则系统会从响应中省略整个结果行。如果您的应用逻辑需要精确的低计数(包括 0)或需要检索单个地点 ID,则必须改用地点计数函数查询数据集。
查询基础知识
下图显示了查询的基本格式:

下文更详细地介绍了该查询的各个部分。
查询要求
直接对数据集执行的 SQL 查询必须指定数据集,并在 SELECT 子句中包含 WITH AGGREGATION_THRESHOLD。否则,查询将失败。
此示例指定 places_insights___us.places 来查询美国的数据集。
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
指定项目名称(可选)
您可以选择在查询中包含项目名称。如果您未指定项目名称,则查询默认为活跃项目。
如果您在不同项目中有关联的同名数据集,或者您要查询活跃项目之外的表,则可能需要添加项目名称。
例如 [project name].[dataset name].places。
指定聚合函数
以下示例展示了支持的 BigQuery 聚合函数。此查询会汇总纽约市帝国大厦 1000 米半径范围内所有地点的评分,以生成评分统计信息:
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(id) AS place_count,
  APPROX_COUNT_DISTINCT(rating) as distinct_ratings,
  COUNTIF(rating > 4.0) as good_rating_count,
  LOGICAL_AND(rating <= 5) as all_ratings_equal_or_below_five,
  LOGICAL_OR(rating = 5) as any_rating_exactly_five,
  AVG(rating) as avg_rating,
  SUM(user_rating_count) as rating_count,
  COVAR_POP(rating, user_rating_count) as rating_covar_pop,
  COVAR_SAMP(rating, user_rating_count) as rating_covar_samp,
  STDDEV_POP(rating) as rating_stddev_pop,
  STDDEV_SAMP(rating) as rating_stddev_samp,
  VAR_POP(rating) as rating_var_pop,
  VAR_SAMP(rating) as rating_var_samp,
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
  AND business_status = "OPERATIONAL"
使用地理多边形和线条过滤结果
如果您未指定位置限制,则数据汇总将应用于整个数据集。您通常会指定位置限制,以搜索特定区域。
1. 使用径向搜索缓冲区 (ST_DWITHIN) 进行过滤
此示例查询指定了以纽约市帝国大厦为中心、半径为 1000 米的目标限制。
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
2. 使用多边形边界进行过滤 (ST_CONTAINS)
您可以使用多边形来指定搜索区域。使用多边形时,多边形的点必须定义一个闭环,其中多边形中的第一个点与最后一个点相同:
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
ST_CONTAINS(ST_GEOGFROMTEXT("""POLYGON((-73.985708 40.75773,-73.993324 40.750298,
                                      -73.9857 40.7484,-73.9785 40.7575,
                                      -73.985708 40.75773))"""), point)
3. 沿路线行程缓冲区过滤 (LINESTRING)
在下一个示例中,您将使用一条由相连点组成的线来定义搜索区域,并将搜索半径设置为该线周围 100 米。该线条类似于由 Routes API 计算的行程路线。路线可能适用于车辆、自行车或行人:
DECLARE route GEOGRAPHY;

SET route = ST_GEOGFROMTEXT("""LINESTRING(-73.98903537033028 40.73655649223003,
                                          -73.93580216278471 40.80955538843361)""");

SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
  ST_DWITHIN(route, point, 100)
按地点数据集字段过滤
根据数据集架构定义的字段优化搜索。根据数据集字段(例如地点 regular_opening_hours、price_level 和客户 rating)过滤结果。
引用数据集架构为您感兴趣的国家/地区定义的数据集中的任何字段。每个国家/地区的数据集架构由两部分组成:
- 所有国家/地区的数据集通用的核心架构。
- 特定国家/地区的架构,用于定义特定于该国家/地区的架构组件。
例如,您的查询可以包含 WHERE 子句,用于定义查询的过滤条件。
在以下示例中,您将返回 tourist_attraction 类型地点的汇总数据,这些地点的 business_status 为 OPERATIONAL,rating 大于或等于 4.0,且 allows_dogs 设置为 true:
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
AND 'tourist_attraction' IN UNNEST(types)
AND business_status = "OPERATIONAL"
AND rating >= 4.0
AND allows_dogs = true
下一个查询会返回至少有 8 个电动车辆充电站的地点:
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  ev_charge_options.connector_count > 8;
按地点主要类型和地点类型过滤
数据集中的每个地点都可以具有:
- 地点类型中定义的类型中,与该地点关联的单一主要类型。例如,主要类型可能是
mexican_restaurant或steak_house。在查询中使用primary_type,可按地点的主要类型过滤结果。 - 地点类型中定义的类型中与该地点关联的多个类型值。例如,一家餐厅可能具有以下类型:
seafood_restaurant、restaurant、food、point_of_interest、establishment。在查询中使用types,根据与地点关联的类型列表过滤结果。
以下查询会返回主类型为 skin_care_clinic 且同时作为 spa 的所有地点的结果:
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  'spa' IN UNNEST(types)
  AND 'skin_care_clinic' = primary_type
按地点 ID 过滤
以下示例计算 5 个地点的平均评分。地点由其 place_id 标识。
DECLARE place_ids ARRAY<STRING>;
SET place_ids = ['ChIJPQOh8YVZwokRE2WsbZI4tOk', 'ChIJibtT3ohZwokR7tX0gp0nG8U',
                 'ChIJdfD8moVZwokRO6vxjXAtoWs', 'ChIJsdNONuFbwokRLM-yuifjb8k',
                 'ChIJp0gKoClawokR0txqrcaEkFc'];
SELECT WITH AGGREGATION_THRESHOLD
 AVG(rating) as avg_rating,
FROM
  `PROJECT_NAME.places_insights___us.places`,
  UNNEST(place_ids) place_id
WHERE
  id = place_id;
从查询结果中排除特定地点 ID
您还可以从查询中排除一组地点 ID。
您可以使用地点 ID 查找工具查找所需的地点 ID,也可以使用 Places API 以编程方式执行文本搜索(新版)请求。
在以下示例中,查询会查找澳大利亚悉尼 2000 邮政编码区域中未出现在 excluded_cafes 数组中的咖啡馆数量。
对于想要从计数中排除自己商家的企业主来说,此类查询可能会很有用。
WITH excluded_cafes AS (
  -- List the specific place IDs to exclude from the final count
  SELECT * FROM UNNEST([
    'ChIJLTcYGz-uEmsRmazk9oMnP5w', 'ChIJeWDDDNOvEmsRF8SMPUwPbhw',
    'ChIJKdaKHbmvEmsRSdxq_1O05bU'
  ]) AS place_id
)

SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `places_insights___au.places` AS places
-- Perform a LEFT JOIN to identify which places are in the exclusion list
LEFT JOIN
  excluded_cafes ON places.id = excluded_cafes.place_id
WHERE
  -- Filter for specific place type and postal code
  places.primary_type = 'cafe'
  AND '2000' IN UNNEST(places.postal_code_names)
  -- Keep only the rows where the join failed (meaning the ID was NOT in the list)
  AND excluded_cafes.place_id IS NULL;
按预定义的数据值过滤
许多数据集字段都有预定义的值。例如:
price_level字段支持以下预定义值:PRICE_LEVEL_FREEPRICE_LEVEL_INEXPENSIVEPRICE_LEVEL_MODERATEPRICE_LEVEL_EXPENSIVEPRICE_LEVEL_VERY_EXPENSIVE
business_status字段支持以下预定义值:OPERATIONALCLOSED_TEMPORARILYCLOSED_PERMANENTLYFUTURE_OPENING
在此示例中,查询会返回纽约市帝国大厦 1000 米半径范围内 business_status 为 OPERATIONAL 的所有花店的数量:
SELECT WITH AGGREGATION_THRESHOLD
COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`
WHERE
ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
AND business_status = "OPERATIONAL"
AND 'florist' IN UNNEST(types)
按营业时间过滤
在此示例中,返回某个地理区域内所有在周五提供欢乐时光的地点数量:
SELECT WITH AGGREGATION_THRESHOLD COUNT(*) AS count
FROM `PROJECT_NAME.places_insights___us.places`,
UNNEST(regular_opening_hours_happy_hour.friday) AS friday_hours
WHERE '17:00:00' BETWEEN friday_hours.start_time AND friday_hours.end_time
AND ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000);
按地区(地址组成部分)过滤
我们的地点数据集还包含一组地址组成部分,可用于根据政治边界过滤结果。每个地址组成部分都由其文本代码名称(例如,纽约市邮政编码的 10002)或地点 ID(ChIJm5NfgIBZwokR6jLqucW0ipg,对应于等效的邮政编码 ID)标识。
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  '10002' IN UNNEST(postal_code_names)
  -- 'ChIJm5NfgIBZwokR6jLqucW0ipg' IN UNNEST(postal_code_ids) -- same filter as above using postal code ID
按电动汽车充电配置过滤
以下示例统计了至少有 8 个电动汽车充电桩的地点数量:
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  ev_charge_options.connector_count > 8;
以下示例统计了至少有 10 个支持快速充电的特斯拉充电器的地点数量:
SELECT WITH AGGREGATION_THRESHOLD
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`, UNNEST(ev_charge_options.connector_aggregation) as connectors
WHERE
  connectors.type ='EV_CONNECTOR_TYPE_TESLA'
  AND connectors.max_charge_rate_kw >= 50
  AND connectors.count >= 10
按数据快照日期过滤
地点数据集包含自 2024 年 1 月起每个月的地点数量数据。如需查询给定月份的地点数据快照,请使用 snapshot_date 字段进行过滤。
例如,以下查询会返回 2024 年 1 月搜索区域中每个地点按主要类型分组的结果:
SELECT WITH AGGREGATION_THRESHOLD
  primary_type,
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places_historical`
WHERE
  snapshot_date = '2024-01-01'
  AND ST_DWITHIN(ST_GEOGPOINT(-73.9857, 40.7484), point, 1000)
GROUP BY
  primary_type;
返回分组结果行
到目前为止,显示的查询在结果中返回一行,其中包含查询的聚合计数。您还可以使用 GROUP BY 运算符,根据分组条件在响应中返回多行。
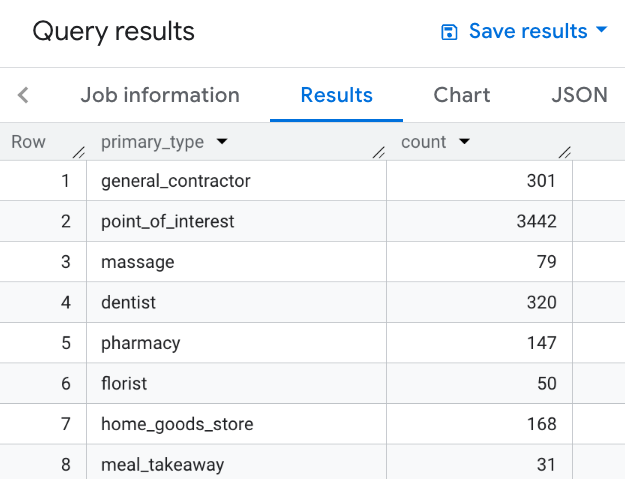
例如,以下查询会返回按搜索区域中每个地点的首要类型分组的结果:
SELECT WITH AGGREGATION_THRESHOLD
  primary_type,
  COUNT(*) AS count
FROM
  `PROJECT_NAME.places_insights___us.places`
WHERE
  ST_DWITHIN(ST_GEOGPOINT(-73.99992071622756, 40.71818785986936), point, 1000)
GROUP BY primary_type
下图显示了此查询的示例输出:
在此示例中,您将定义一个位置表。然后,对于每个地点,您需要计算附近餐厅的数量,即 1000 米范围内的餐厅数量:
WITH my_locations AS (
  SELECT 'Location 1' AS name, ST_GEOGPOINT(-74.00776440888504, 40.70932825380786) AS location
  UNION ALL
  SELECT 'Location 2' AS name, ST_GEOGPOINT(-73.98257192833559, 40.750738934863215) AS location
  UNION ALL
  SELECT 'Location 3' AS name, ST_GEOGPOINT(-73.94701794263223, 40.80792954838445)  AS location
)
SELECT WITH AGGREGATION_THRESHOLD
  l.name,
  COUNT(*) as count
FROM
  `PROJECT_NAME.places_insights___us.places` AS p
JOIN
   my_locations l
ON
  ST_DWITHIN(l.location, p.point, 1000)
WHERE
  primary_type = "restaurant"
  AND business_status = "OPERATIONAL"
GROUP BY
  l.name
下图显示了此查询的示例输出:
